
Loading...
Ja: Datengestützte, datenschutzfreundliche Personalisierung steigert die Kundenbindung zuverlässig und kann den Umsatz bei Nutzung von First-Party-Daten, echter Entscheidunglogik und sichtbaren Datenschutzkontrollen um niedrige zweistellige Prozentwerte steigern. Der Mechanismus ist einfach: Relevante Nachrichten zum richtigen Zeitpunkt, gestützt auf eine tatsächlich erteilte Kundeneinwilligung, erzielen mehr Aufmerksamkeit und Vertrauen als je ein generischer Massenversand.
TL;DR:
- Eine Personalisierung auf Basis von First-Party-Daten, Entscheidungslogik und Datenschutzkontrollen bringt typischerweise eine Umsatzsteigerung von 10 bis 15 %, insbesondere bei skalierter Umsetzung.
- Effektive Personalisierung erfordert eine konsolidierte Customer Data Platform, Echtzeit-Entscheidungslogik, modulare Vorlagen und ein funktionierendes Tracking.
- Trigger-basierte Taktiken wie Warenkorbabbrüche und Verlängerungserinnerungen erzielen ein höheres Engagement als das verfrühte Ansprechen von Mikro-Segmenten.
- Ein ordnungsgemäßes Datenschutzmanagement mit klaren Erklärungen und Einstellungsoptionen verbessert das Kundenvertrauen und die Bereitschaft zur Datenweitergabe erheblich.
- Die Nutzung von Kontrollgruppen (Holdout-Gruppen) für inkrementelle Tests hilft dabei, die tatsächliche Wirkung der Personalisierung genau zu messen, anstatt sich nur auf Standard-A/B-Tests zu verlassen.
Marketing-Teams müssen dies nicht blind glauben. Unternehmen, die sich durch Personalisierung auszeichnen, erzielen oft eine Umsatzsteigerung von 10 bis 15 %, wobei die Ergebnisse einzelner Unternehmen je nach Kategorie und Ausgangsreife stärker variieren. Dieselbe Untersuchung ergab, dass 71 % der Verbraucher heute maßgeschneiderte Interaktionen erwarten und 76 % frustriert sind, wenn eine Marke diese nicht liefert.

Diese Erwartungslücke zeigt sich direkt in den Leistungskennzahlen: Klickraten, Öffnungsraten, Konversionsraten und Wiederholungskäufe reagieren alle positiv auf Relevanz. Ein Käufer, der Produkte sieht, die zu seinem bisherigen Stöberverhalten passen, konvertiert häufiger als jemand, dem eine generische Startseite präsentiert wird. Ein Abonnent, der eine Verlängerungserinnerung passend zu seinem tatsächlichen Nutzungsverhalten erhält, verlängert sein Abo häufiger als jemand, der dieselbe E-Mail bekommt wie alle anderen auf der Liste.
Die Einbindung von First-Party-Datenquellen kann Kosteneinsparungen von bis zu 30 % und Umsatzsteigerungen von bis zu 20 % bewirken, da Marken so auf kritische Momente reagieren können, anstatt zu raten, wie eine Analyse von BCG für Think with Google zeigt. Das Muster in dieser Forschung weist auf drei Kräfte hin, die hier wirken:
Akademische Arbeiten zur kausalen Inferenz und zur Modellierung von Behandlungseffekten, zusammengefasst im Überblick der Harvard Business School über Personalisierungsmethoden, unterstreichen einen schwerwiegenderen Punkt: Die Messung des tatsächlichen Effekts eines personalisierten Angebots – und nicht nur seiner Korrelation mit einem Verkauf – unterscheidet ein echtes Programm von bloßem Rätselraten.
Personalisierung scheitert meistens nicht an schlechten kreativen Inhalten, sondern an fehlender technischer Infrastruktur. Bevor eine Marke glaubwürdig Relevanz versprechen kann, müssen vier Dinge gegeben sein.
McKinseys Forschung zur Skalierung von personalisiertem Marketing stellt fest, dass führende Unternehmen dies als Infrastruktur betrachten und nach dem Aufbau der Grundlage jährlich eine große Menge an Tests durchführen, anstatt Personalisierung als reine Kampagne zu betrachten.
Pro-Tipp: Überprüfen Sie Ihre Identitätsauflösung, bevor Sie sich dem kreativen Content widmen: Eine Entscheidungs-Engine, die mit doppelten oder widersprüchlichen Profilen gefüttert wird, personalisiert zielsicher für die falsche Person.
Nicht jede Taktik verdient die gleiche Investition. Hier ist eine praktische Reihenfolge der Schritte, grob abgestimmt auf Aufwand und Ertrag.
Der rote Faden bei allen fünf Schritten: Jeder Schritt erfordert ein saubereres Signal als der vorherige, und das Überspringen eines Schritts führt tendenziell zu einer Personalisierung, die zwar raffiniert aussieht, aber nicht besser abschneidet als eine gut erstellte Segmentliste.
Pro-Tipp: Begrenzen Sie die Anzahl der aktiven Mikro-Segmente, die Sie gleichzeitig ausführen. Teams, die Zielgruppen zu stark aufteilen, enden oft mit Segmenten, die zu klein sind, um sie zuverlässig zu testen.
Kunden sind eher bereit, Daten zu teilen und auf Personalisierung zu reagieren, wenn sie sich dabei in Kontrolle fühlen – und nicht umgekehrt. Googles „Drei M“-Framework (Sinnvoll/Meaningful, Einprägsam/Memorable, Handhabbar/Manageable) bietet Marketern eine konkrete Möglichkeit, dieses Gefühl zu erzeugen, anstatt den Datenschutz nur formal zu erfüllen.
Nutzer, die ein hohes Maß an Kontrolle über ihre Daten empfinden, reagieren dreimal so häufig positiv auf Werbung und finden diese doppelt so oft relevant. Positive Datenerlebnisse führen zu einer Steigerung des Markenvertrauens um 11 bis 16 %. Personalisierung, die sich mysteriös anfühlt, wirkt invasiv; Personalisierung, die sich selbst erklärt, wirkt hilfsbereit – selbst wenn die zugrunde liegende Datennutzung ähnlich ist.
Diese Kontrollmechanismen wirken sich auch positiv auf das Tracking aus. Eine einwilligungsbasierte Modellierung – bei der Segmentierung und Scoring nur auf Daten basieren, die Kunden aktiv zur Weitergabe freigegeben haben – hält Ihre Entscheidungs-Engine regelkonform und sorgt dafür, dass der Vertrauenskreis intakt bleibt, anstatt Datenschutz als einmaliges juristisches Häkchen abzutun.
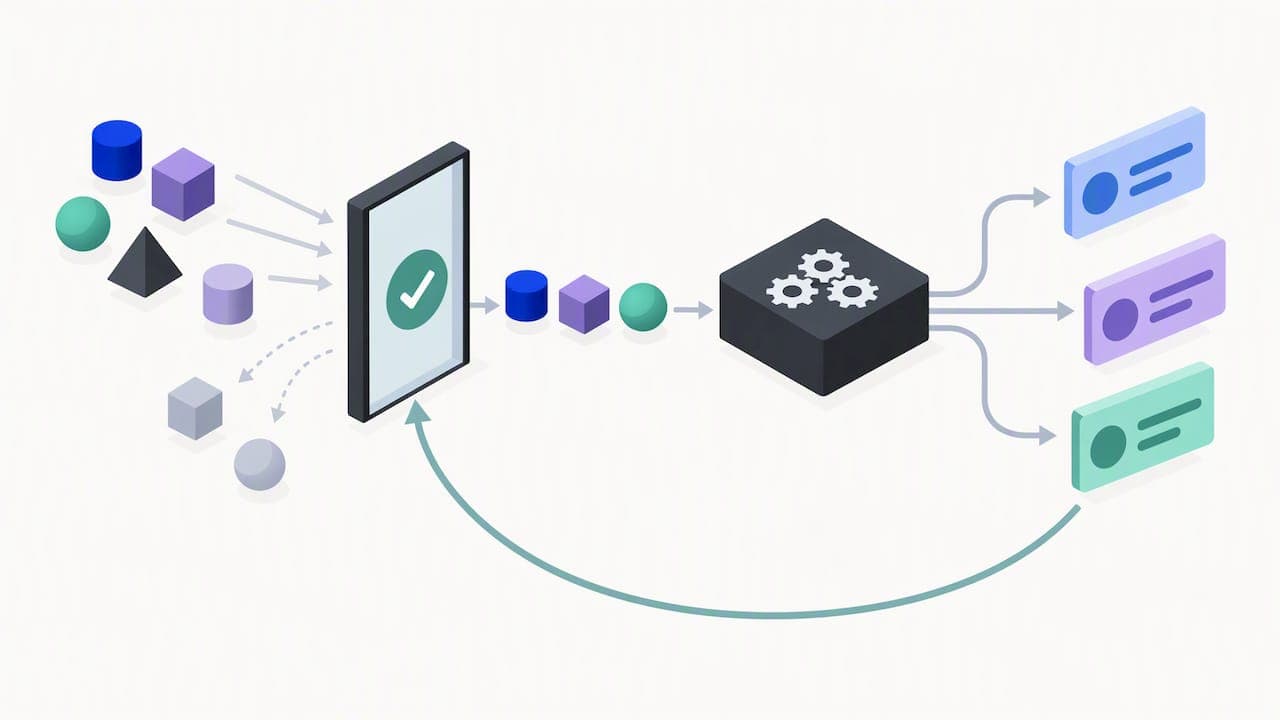
Standard-A/B-Tests beantworten die Frage: „Hat Version B Version A übertroffen?“. Sie beantworten nicht die Frage: „Hätte dieser Kunde sowieso gekauft?“. Dafür benötigen Sie Inkrementalitäts- oder Kontrollgruppentests (Holdout-Tests): eine Gruppe, die überhaupt keine personalisierte Behandlung erhält, verglichen mit der behandelten Gruppe über denselben Zeitraum.
Pro-Tipp: Lassen Sie Ihre Holdout-Gruppe für mindestens einen vollständigen Kaufzyklus laufen, bevor Sie Schlüsse ziehen. Ein zweiwöchiger Holdout bei einem 45-tägigen Kaufzyklus wird Ihnen fast nichts verraten.
Ein Pilotversuch beweist den Wert, bevor Sie ein größeres Budget anfordern. Halten Sie ihn kompakt und zeitlich begrenzt.
Ein Hub-and-Spoke-Teammodell funktioniert hier gut: Ein zentrales Team kümmert sich um die Datenebene, die Entscheidungsregeln und das Tracking, während die Kanalverantwortlichen (E-Mail, Website, App) für den Content und die kanalspezifische Umsetzung zuständig sind. Diese Aufteilung hält den Piloten agil, ohne die zentrale Kontrolle darüber zu verlieren, was tatsächlich getestet wird.
Entscheidungs-Engines können die richtige Nachricht für den richtigen Kunden auswählen, aber die Nachricht muss sich dennoch so lesen, als wäre sie für einen Menschen geschrieben und nicht von einer Vorlage zusammengestückelt. Hier scheitern KI-gestützte Texte in großem Maßstab in der Regel: Dynamische E-Mail-Betreffzeilen, Website-Mikrotexte und personalisierte Schnipsel, die in großen Mengen generiert werden, tragen oft die steifen, repetitiven Merkmale maschinell geschriebener Texte. Das untergräbt das Vertrauen, das die Personalisierung eigentlich aufbauen soll.
Es gibt Tools, die KI-generierten Text nehmen und ihn so umstrukturieren, dass er natürlich klingt, während sie gleichzeitig Zielkeywords für SEO integrieren und die Wahrscheinlichkeit verringern, dass er von Detektoren wie Turnitin, GPTZero oder Copyleaks markiert wird. Für Teams, die wöchentlich Hunderte von personalisierten Betreffzeilen oder dynamischen Snippets generieren, hilft ein menschlicher Korrekturdurchlauf vor dem Versand, den Ton konsistent und wirklich lesbar zu halten, anstatt eine Entscheidungs-Engine Texte verschicken zu lassen, die so klingen, als hätte sie niemand verfasst.
Der Online-Handel bleibt das klarste Anwendungsbeispiel: Produktempfehlungen und Warenkorb-Abbruch-Trigger, die mit dem Browserverlauf verknüpft sind, übertreffen generische Werbe-E-Mails konstant, da das Signal (was sich jemand gerade angesehen hat) direkt mit dem Angebot übereinstimmt.
Abonnement- und Medienunternehmen setzen auf Verlängerungs-Timing und Content-Affinitäts-Personalisierung. Sie spielen Empfehlungen aus, basierend darauf, was ein Abonnent bereits konsumiert hat, und nicht auf dem, was einfach nur neu ist.
Finanzdienstleister nutzen die lebensphasenbezogene Personalisierung behutsam, indem sie die Produktansprache (eine erste Kreditkarte, eine Hypothekenanfrage) genau darauf abstimmen, wo sich ein Kunde in einer langfristigen Beziehung befindet, wobei Datenschutz-Framing angesichts der Sensibilität der beteiligten Daten eine zusätzliche Rolle spielt.
Reise- und Gastgewerbemarken personalisieren eher nach Timing als nach Inhalt. Sie lösen Angebote rund um vergangene Buchungszeitfenster und den Status im Treueprogramm aus anstatt über granulare Verhaltensverfolgung, da die Buchungsfrequenz natürlich niedriger ist als die Kauffrequenz im Einzelhandel.
Über alle vier Branchen hinweg erzielen die stärksten Ergebnisse diejenigen, die einen klaren Auslöser (ein reales Verhaltens- oder Lebenszyklussignal) mit einer Nachricht paaren, die sich selbst erklärt – und nicht dadurch, dass sie einfach mehr Datenpunkte um ihrer selbst willen hinzufügen.
Über-Personalisierung ist der häufigste Fehler. Teams, die Mikro-Segmente jagen, bevor ihre Daten und Messmethoden bereit dafür sind, enden mit Dutzenden kleiner Zielgruppen, von denen keine groß genug ist, um sie zuverlässig zu testen – und mit Produktionskosten für Inhalte, die jeden messbaren Zuwachs übertreffen.
Die Missachtung der Einwilligung ist der zweite Fehler. Entscheidungsmodelle auf Basis von Daten aufzubauen, deren Nutzung Kunden niemals explizit zugestimmt haben, birgt sowohl ein Compliance-Risiko als auch ein Vertrauensproblem, sobald ein Kunde bemerkt, wie viel eine Marke anscheinend über ihn weiß.
Mangelnde Disziplin beim Messen ist der dritte und teuerste Fehler. Teams, die sich allein auf Standard-A/B-Ergebnisse verlassen, ohne eine Holdout-Gruppe einzubeziehen, überschätzen regelmäßig den Wert der Personalisierung, weil sie die Korrelation mit der Kaufabsicht anstelle des tatsächlichen Effekts der Nachricht messen.
Ein viertes, leiseres Problem ist die Ermüdung durch Inhalte: Selbst gut gezielte Botschaften verlieren an Wirksamkeit, wenn der zugrunde liegende Text repetitiv oder offensichtlich als Vorlage erkennbar ist. Aus diesem Grund müssen die Qualität der Inhalte und die Personalisierungslogik gemeinsam verbessert werden, nicht nacheinander.
Generative KI wandelt sich von einer kreativen Abkürzung zu einer Engagement-Funktion. McKinseys Berichte über GenAI-gestützte Personalisierung deuten darauf hin, dass erste Pilotversuche das Engagement um etwa 10 % steigern, wenn skalierte Text- und Tonvariationen mit Mess-Leitplanken kombiniert werden. Ein Muster, das sich bei Reifung der Tools wahrscheinlich auch auf Bilder und Videos ausdehnen wird.
Auch die Entscheidungsfindung beschleunigt sich. Unternehmen, die First-Party-Daten konsolidieren und echte Entscheidungs-Engines aufbauen, beginnen, Personalisierung als eine dauerhaft laufende Fähigkeit zu betrachten und kontinuierliche Tests anstelle vierteljährlicher Kampagnen durchzuführen – ein Wandel, den BCG als wettbewerbsfähigen Burggraben bezeichnet, der aufereneren Pipelines und schnellerer Aktivierung beruht.
Die Datenschutz-Infrastruktur verschmilzt zunehmend mit der Personalisierungs-Infrastruktur, anstatt getrennt von ihr zu existieren. Die einwilligungsbasierte Modellierung, bei der nur explizit freigegebene Daten die Entscheidungs-Engine speisen, entwickelt sich zum Standard anstelle eines Compliance-Anhängsels. Dies sollte es erleichtern, die Vertrauensgewinne durch die „Drei M“ bei der Skalierung von Programmen aufrechtzuerhalten.
Erwarten Sie, dass die nächste Welle von Tools die Grenze zwischen Anpassung (was ein Benutzer manuell einstellt) und Personalisierung (was ein System ableitet) verschwimmen lässt – eine Unterscheidung, die die Nielsen Norman Group seit Langem als wichtig für die Steuerung von Benutzererwartungen und Pflegeaufwand einstuft, da diese Systeme autonomer werden.
Priorisieren Sie den Nutzen vor Raffinesse: Ein einfacher, gut getimter Trigger schlägt ein ausgeklügeltes Mikro-Segment, nach dem niemand gefragt hat. Messen Sie mit Kontrollgruppen und nicht nur über A/B-Vergleiche, sonst verwechseln Sie die Kaufabsicht mit der Wirkung. Machen Sie den Datenschutz sichtbar und verstecken Sie ihn nicht, denn Kunden, die Ihre Datennutzung verstehen, reagieren positiver – nicht negativer – auf Personalisierung.
Der zugrunde liegende Hauptfehler bei all dem ist die Reihenfolge: Teams personalisieren, bevor sie messen können, und bitten erst um Einwilligung, wenn sie das Targeting-Modell bereits gebaut haben. Bringen Sie diese Reihenfolge in Ordnung, und der Rest wird weitgehend einfacher.
— Tilen
Teams, die Personalisierung in großem Stil betreiben, stoßen irgendwann an dieselbe Wand: Entscheidungs-Engines können die richtige Nachricht auswählen, aber das manuelle Erstellen von Hunderten wirklich lesbaren Varianten, Betreffzeilen, Website-Snippets und dynamischen Produkttexten überfordert jedes Content-Team.
Semihuman.ai bietet Tarife an, die auf beide Seiten dieses Problems zugeschnitten sind. Die Free-, Basic- und Pro-Tarife eignen sich für Marketing-Teams, die von KI entworfene E-Mail-Varianten oder Landingpage-Snippets direkt über die Benutzeroberfläche menschlich klingen lassen. Die Developer-, Business- und Enterprise-Tarife bieten Entwicklerteams den API-Zugriff, um die Humanisierung als Schritt in eine bestehende Personalisierungspipeline einzubauen, sodass dynamische Inhalte einen Lesbarkeits-Check durchlaufen, bevor sie jemals einen Kunden erreichen. Für ein Tool, das auf KI-gestützte Content-Workflows und reale Anwendungsfälle ausgelegt ist, lohnt sich ein Blick auf die von Axio Networks zusammengestellten Beispiele parallel zu Ihrem eigenen Pilotversuch.
Ja, wenn sie auf First-Party-Daten und echter Entscheidungslogik statt auf Ratespielen basiert. Unternehmen, die Personalisierung gut umsetzen, verzeichnen messbare Zuwächse bei Umsatz und Kundenreaktion. McKinsey berichtet hierbei von einer Umsatzsteigerung von 10 bis 15 % bei Vorreitern.
Die Definitionen der „4 Ds“ variieren in Marketing-Quellen und sind nicht an ein einzelnes Standard-Framework gekoppelt. Die in der Forschung am konsistentesten genannte Grundlage besteht aus First-Party-Daten, Entscheidungslogik (Decisioning), modularen Inhalten und Messung (Measurement), die zusammen als praktische Anforderungen für Personalisierung im großen Maßstab dienen.
Personalisiertes Engagement bezeichnet Interaktionen, die auf das Verhalten, die Vorlieben oder die Lebenszyklusphase eines einzelnen Kunden zugeschnitten sind, anstatt eine generische Nachricht an alle zu senden. Es basiert auf einem System, das vorhersagt, was ein bestimmter Kunde benötigt. Die Nielsen Norman Group unterscheidet dies von der Anpassung (Customization), bei der der Nutzer seine Einstellungen manuell selbst festlegt.
Personalisierung verbessert das Kundenerlebnis, indem sie Inhalte, Angebote und Timing an das nachgewiesene Verhalten eines Kunden anpasst, anstatt auf einen Einheitsansatz zu setzen, was irrelevante Botschaften reduziert. Sie funktioniert am besten in Kombination mit sichtbaren Datenschutzkontrollen, da Kunden, die sich bei ihren Daten in Kontrolle fühlen, laut der Forschung von Think with Google positiver auf Personalisierung reagieren.
Das größte Risiko besteht darin, Personalisierung ausschließlich mit Standard-A/B-Tests zu messen, was die Wirkung verfälschen kann, da die Kaufabsicht mit der tatsächlichen Wirkung der Nachricht verwechselt wird. Die Durchführung eines Kontrollgruppentests (Holdout) über einen vollständigen Kaufzyklus hinweg liefert ein präziseres Bild darüber, ob die Personalisierung das Ergebnis tatsächlich vorantreibt.
Start
Texte vermenschlichen
kostenlos!
Humanisieren