
Loading...
네: 데이터 중심의 프라이버시 우선 개인화는 자사 데이터, 실시간 의사결정 로직, 가시적인 프라이버시 제어 기능을 기반으로 할 때 고객 참여도를 안정적으로 높이며 두 자릿수 초반대의 매출 상승 효과를 낼 수 있습니다. 메커니즘은 간단합니다. 고객이 실제로 허용한 동의를 바탕으로, 적절한 순간에 관련성 있는 메시지를 보내는 것이 무분별한 대량 발송보다 훨씬 더 많은 관심과 신뢰를 얻습니다.
요약 (TL;DR):
- 자사 데이터, 의사결정 로직, 프라이버시 제어 기능을 기반으로 한 개인화는 특히 대규모로 실행할 때 일반적으로 10~15%의 매출 상승을 이끌어냅니다.
- 효과적인 개인화를 위해서는 통합된 고객 데이터 플랫폼, 실시간 의사결정 엔진, 모듈형 템플릿, 그리고 성과 측정 체계가 제대로 갖춰져야 합니다.
- 장바구니 이탈이나 구독 갱신 알림 같은 트리거 기반 전술은 무리하게 마이크로 세그먼트를 타겟팅하는 것보다 더 높은 참여율을 기록합니다.
- 명확한 설명과 선호도 제어 기능을 갖춘 올바른 프라이버시 관리는 고객의 신뢰와 데이터 공유 의향을 크게 향상시킵니다.
- 증분 테스트(Incrementality testing)를 위해 홀드아웃 그룹(대조군)을 활용하면 단순한 일반 A/B 테스트를 넘어 개인화의 진정한 영향을 정확하게 평가하는 데 도움이 됩니다.
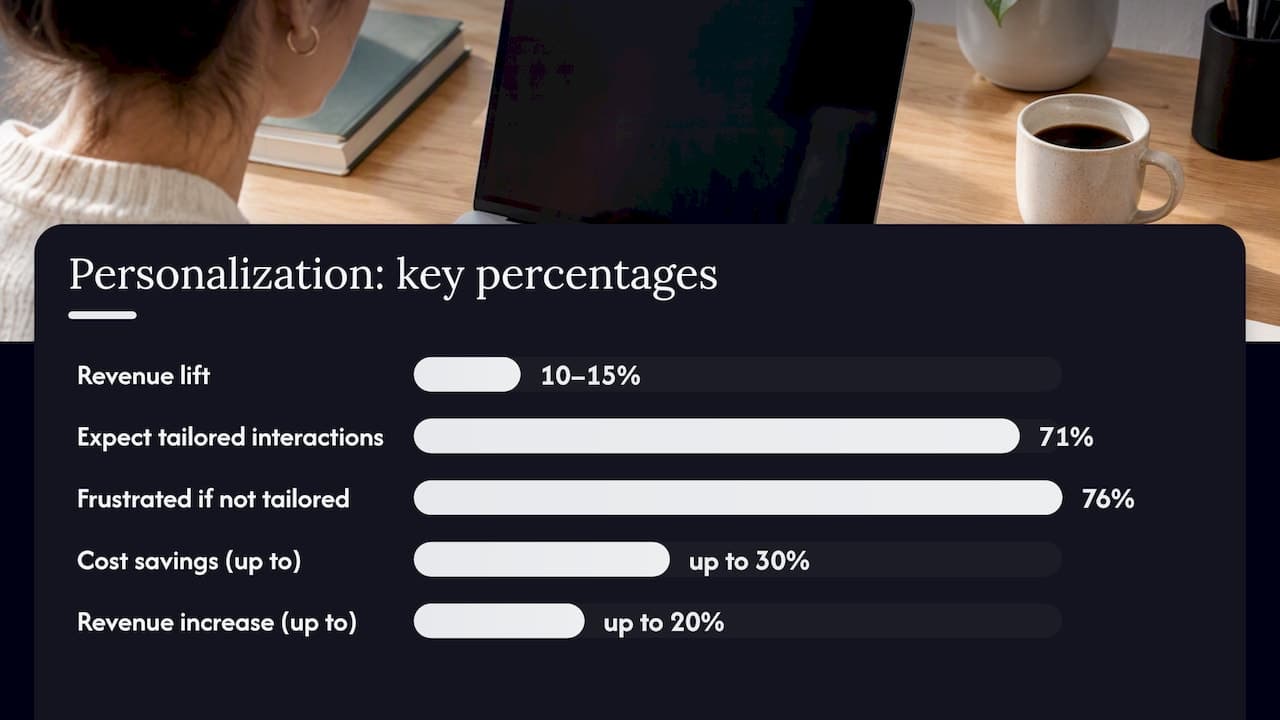
마케팅 팀이 이를 무조건 믿을 필요는 없습니다. 개인화에 뛰어난 기업들은 일반적으로 10~15%의 매출 상승을 창출하며, 개별 기업의 결과는 카테고리나 초기 성숙도에 따라 더 넓은 편차를 보입니다. 동일한 연구에 따르면 소비자의 71%가 이제 맞춤형 상호작용을 기대하며, 76%는 브랜드가 이를 제공하지 못할 때 좌절감을 느낍니다.
이러한 기대치 격차는 클릭률, 오픈율, 전환율, 재구매율 등의 성과 지표에 직접적으로 나타납니다. 자신이 이미 둘러본 상품과 연관된 상품을 보는 쇼핑객은 일반적인 홈페이지만 보는 쇼핑객보다 더 자주 구매로 전환됩니다. 실제 사용 패턴에 맞춰 갱신 알림을 받는 구독자는 리스트에 있는 다른 모든 사람들과 똑같은 이메일을 받는 사람들보다 훨씬 더 자주 구독을 갱신합니다.
BCG가 Think with Google을 위해 진행한 분석에 따르면, 자사 데이터 소스를 통합하면 브랜드가 짐작에 의존하는 대신 주요 순간에 대응할 수 있게 되므로 최대 30%의 비용 절감과 최대 20%의 매출 증가를 이룰 수 있습니다. 이러한 연구 전반에 걸쳐 나타나는 패턴은 다음 세 가지 요소가 핵심적인 역할을 하고 있음을 보여줍니다.
하버드 경영대학원의 개인화 방법 개요에 요약된 인과 추론 및 처치 효과 모델링에 관한 학술 연구는 더욱 중요한 시사점을 강조합니다. 즉, 단순히 판매와의 상관관계가 아니라 맞춤형 제안의 실제 효과를 측정하는 것이야말로 진짜 프로그램과 단순한 짐작을 가르는 기준이라는 점입니다.
개인화가 실패하는 가장 큰 이유는 크리에이티브가 나빠서가 아니라 기반 시스템이 부실하기 때문입니다. 브랜드가 신뢰할 수 있는 관련성을 약속하려면 네 가지 요소가 반드시 존재해야 합니다.
맥킨지의 맞춤형 마케팅 확장에 관한 연구에 따르면, 선도적인 조직들은 개인화를 일회성 캠페인으로 여기지 않고 인프라로 대우하며 일단 기반이 구축되면 매년 대규모 테스트를 실행합니다.
프로 팁: 크리에이티브를 건드리기 전에 신원 해상도를 먼저 점검하세요. 중복되거나 상충되는 프로필이 입력된 의사결정 엔진은 엉뚱한 사람에게 자신 있게 개인화를 시도하게 됩니다.
모든 전술에 똑같은 투자를 할 필요는 없습니다. 투입되는 노력과 얻을 수 있는 보상에 맞춰 대략적으로 정렬된 실용적인 실행 순서는 다음과 같습니다.
다섯 가지 단계 전체에 흐르는 공통된 스레드는 각 단계가 이전 단계보다 더 깨끗한 신호를 필요로 한다는 점이며, 단계를 건너뛰면 정교해 보이지만 잘 구축된 세그먼트 리스트보다 나을 게 없는 개인화가 만들어지기 쉽습니다.
프로 팁: 동시에 운영하는 활성 마이크로 세그먼트의 수를 제한하세요. 오디언스를 너무 잘게 쪼개는 팀은 결국 신뢰할 수 있는 테스트를 수행하기에는 너무 작은 세그먼트를 갖게 되곤 합니다.
고객은 자신의 데이터를 통제하고 있다고 느낄 때 데이터를 공유하고 개인화에 반응할 가능성이 더 커집니다. 구글의 3M 프레임워크(의미 있는(Meaningful), 기억에 남는(Memorable), 관리 가능한(Manageable))는 마케터들이 단순히 규정을 준수하는 것을 넘어 이러한 느낌을 구체적으로 구축할 수 있는 방법을 제시합니다.
데이터에 대한 통제력이 높다고 느끼는 사용자는 광고에 긍정적으로 반응할 확률이 3배 더 높고 관련성을 느낄 확률이 2배 더 높으며, 긍정적인 프라이버시 경험은 브랜드 신뢰도의 11~16% 상승으로 이어집니다. 의도가 불투명한 개인화는 침해적으로 느껴지지만, 스스로를 설명하는 개인화는 기저의 데이터 사용이 비슷하더라도 유용하게 느껴집니다.
이러한 제어 기능은 측정에도 피드백을 제공합니다. 고객이 명시적으로 공유하기로 동의한 데이터만을 기반으로 세그먼트화하고 점수를 매기는 동의 기반 모델링(Consent-aware modeling)은 의사결정 엔진을 규정에 준수하도록 유지하고, 프라이버시를 일회성 법적 체크박스로 다루는 대신 신뢰 루프를 온전하게 유지해 줍니다.
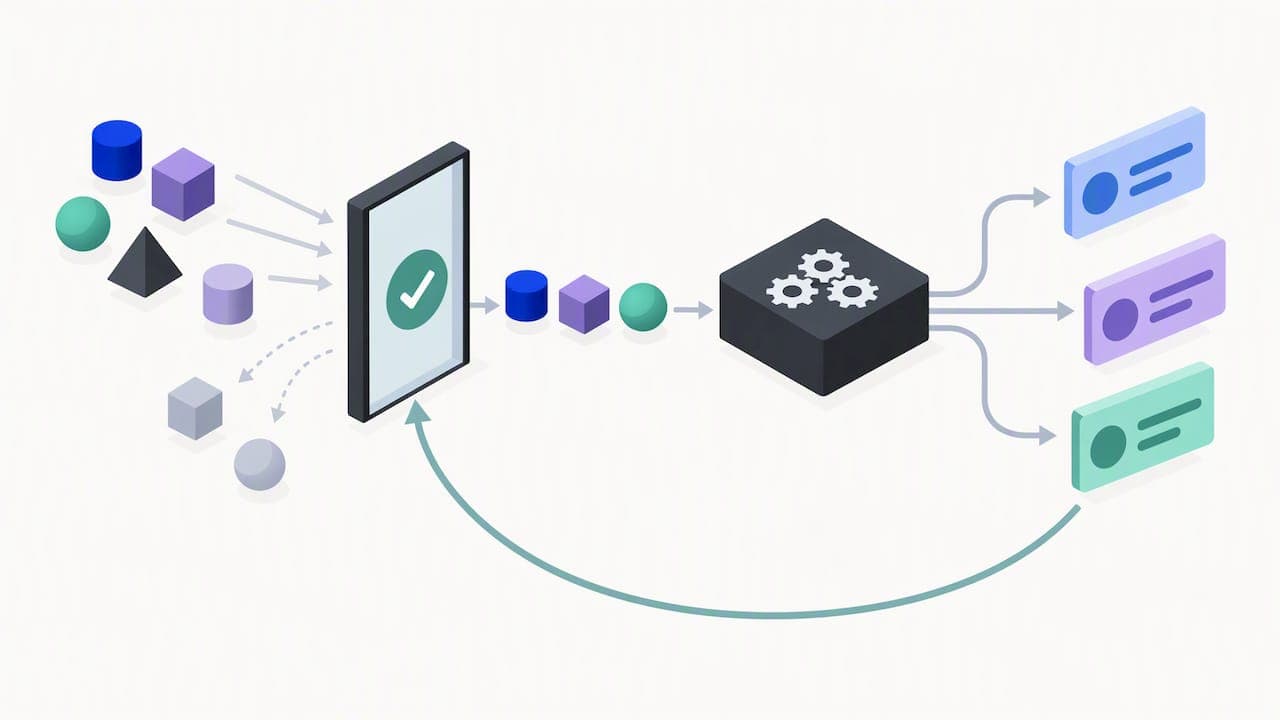
표준 A/B 테스트는 버전 B가 버전 A보다 성과가 좋았는가?에 대한 답은 주지만, 이 고객이 개인화가 없었어도 어차피 구매 전환을 일으켰을 것인가?에는 답하지 못합니다. 이를 위해서는 증분 테스트(Incrementality) 또는 홀드아웃 테스트(Holdout testing)가 필요합니다. 즉, 개인화된 처치를 전혀 받지 않는 그룹을 설정하고, 동일 기간 동안 처치를 받은 그룹과 비교하여 측정하는 방식입니다.
프로 팁: 결론을 내리기 전에 홀드아웃 그룹을 최소한 하나의 전체 구매 주기에 걸쳐 실행하세요. 45일짜리 구매 주기에 2주일짜리 홀드아웃을 적용하는 것은 거의 아무런 정보도 주지 못합니다.
파일럿은 더 큰 예산을 요구하기 전에 가치를 증명해 줍니다. 범위를 좁히고 기간을 엄격하게 제한하세요.
여기서는 허브앤스포크(Hub-and-spoke) 팀 모델이 효과적입니다. 중앙 팀이 데이터 레이어, 의사결정 규칙, 측정을 담당하고 채널 오너(이메일, 온사이트, 앱)가 크리에이티브와 채널별 실행을 담당하는 방식입니다. 이러한 역할 분담은 실제로 테스트되는 내용에 대한 중앙의 감독을 잃지 않으면서도 파일럿을 신속하게 진행할 수 있게 해줍니다.
의사결정 엔진은 올바른 고객에게 올바른 메시지를 선택할 수 있지만, 그럼에도 그 메시지는 템플릿이 조립한 것이 아니라 사람이 직접 쓴 것처럼 읽혀야 합니다. 바로 이 지점에서 대규모 AI 지원 카피가 한계를 드러냅니다. 동적 이메일 제목, 온사이트 마이크로카피, 대량 생성된 개인화 스니펫은 기계가 쓴 텍스트 특유의 딱딱하고 반복적인 낌새를 풍기기 쉬우며, 이는 개인화가 구축해야 할 신뢰를 깎아먹습니다.
AI가 생성한 텍스트를 자연스럽게 읽히도록 재구성하는 동시에 SEO를 위한 타겟 키워드를 통합하고 Turnitin, GPTZero, Copyleaks 같은 탐지기에 걸릴 확률을 낮춰주는 도구들이 존재합니다. 매주 수백 개의 개인화된 제목이나 동적 스니펫을 생성하는 팀의 경우, 배포하기 전에 해당 카피를 휴머나이제이션(Humanization) 과정을 거치면 의사결정 엔진이 아무도 쓰지 않은 것 같은 텍스트를 발송하도록 내버려 두는 대신, 톤을 일관되고 진정성 있게 읽히도록 유지하는 데 도움이 됩니다.
리테일 이커머스는 여전히 가장 명확한 사례입니다. 브라우징 기록과 연계된 상품 추천 및 장바구니 이탈 트리거는 일반적인 프로모션 이메일보다 일관되게 뛰어난 성과를 냅니다. 신호(누군가가 방금 무엇을 보았는지)가 제안과 직접적으로 매핑되기 때문이죠.
구독 및 미디어 비즈니스는 단순 신상품이 아니라 구독자가 이미 소비한 콘텐츠를 기반으로 추천을 띄우는 갱신 타이밍 및 콘텐츠 친밀도 개인화를 활용합니다.
금융 서비스는 고객이 오랜 관계 속에서 어디에 위치해 있는지(첫 신용카드 발급, 주택담보대출 문의 등)에 따라 제품 메시지를 맞춤화하는 라이프사이클 단계별 개인화를 신중하게 활용하며, 데이터의 민감성을 고려할 때 프라이버시 프레이밍이 추가적인 역할을 합니다.
여행 및 호스피탈리티 브랜드는 세밀한 행동 추적보다는 과거 예약 창구(booking window)나 로열티 등급 상태를 중심으로 오퍼를 트리거하며, 콘텐츠보다는 타이밍에 맞춰 개인화를 진행합니다. 리테일 구매 주기에 비해 예약 빈도가 자연스럽게 낮기 때문입니다.
이 네 가지 분야 모두에서 가장 강력한 결과는 단순한 자기 목적적인 데이터 포인트 추가가 아니라, 명확한 트리거(실제 행동 또는 라이프사이클 신호)와 스스로를 설명하도록 만들어진 메시지의 결합에서 나옵니다.
과도한 개인화(Over-personalizing)는 가장 흔한 실패 원인입니다. 데이터와 측정이 준비되지 않은 상태에서 마이크로 세그먼트를 쫓는 팀은 수십 개의 작은 오디언스를 갖게 되며, 이 중 신뢰할 수 있는 테스트를 수행할 만큼 큰 규모는 없고 크리에이티브 제작 비용만 측정 가능한 상승 폭을 압도하게 됩니다.
동의 무시는 두 번째 실패 원인입니다. 고객이 사용에 명시적으로 동의한 적 없는 데이터를 기반으로 의사결정 모델을 구축하면, 브랜드가 얼마나 많은 것을 알고 있는지 고객이 알아차리는 순간 컴플라이언스 리스크와 신뢰 문제가 동시에 발생합니다.
빈약한 측정 규율은 세 번째이자 가장 비용이 많이 드는 실패 원인입니다. 홀드아웃 그룹 없이 표준 A/B 결과에만 의존하는 팀은 메시지의 실제 효과가 아니라 의도와의 상관관계를 측정하고 있기 때문에 정기적으로 개인화의 가치를 과대평가하게 됩니다.
네 번째이면서 조용한 문제는 콘텐츠 피로도입니다. 심지어 잘 타겟팅된 메시지라 하더라도 기저의 카피가 반복적이거나 명확하게 템플릿화되어 있으면 효과가 떨어집니다. 이것이 바로 크리에이티브 품질과 개인화 로직이 순차적이 아니라 함께 향상되어야 하는 이유입니다.
생성형 AI는 크리에이티브의 지름길에서 참여 기능(Engagement function)으로 진화하고 있습니다. 젠AI 기반 개인화에 대한 맥킨지의 보고서에 따르면, 확장된 카피와 톤 변형이 측정 가이드라인과 결합될 때 초기 파일럿에서 참여도가 약 10% 향상되었으며, 이러한 패턴은 도구가 성숙해짐에 따라 이미지와 비디오 영역으로 확장될 것으로 보입니다.
의사결정 속도도 빨라지고 있습니다. 자사 데이터를 통합하고 실제 의사결정 엔진을 구축하는 조직들은 분기별 캠페인이 아닌 지속적인 테스트를 실행하며 개인화를 상시 역량으로 대하기 시작했습니다. BCG가 더 빠른 파이프라인과 빠른 활성화를 기반으로 구축된 경쟁 우위의 해자(Moat)로 규정하는 변화입니다.
프라이버시 인프라는 따로 떨어져 있는 것이 아니라 개인화 인프라와 융합되고 있습니다. 명시적으로 공유된 데이터만 의사결정 엔진에 공급하는 동의 기반 모델링은 컴플라이언스용 애드온이 아닌 기본 아키텍처로 자리 잡고 있으며, 이는 프로그램이 확장됨에 따라 3M으로부터 얻는 신뢰 증대를 더 지속 가능하게 만들어 줄 것입니다.
다음 세대의 도구들은 사용자가 수동으로 설정하는 것(커스터마이제이션)과 시스템이 추론하는 것(개인화) 사이의 경계를 흐리게 만들 것으로 예상됩니다. 닐슨 노먼 그룹(Nielsen Norman Group)이 이러한 시스템이 더 자율화됨에 따라 사용자 기대치와 유지 관리 부담을 관리하는 데 중요하다고 오랫동안 지적해 온 구분점입니다.
요령보다는 혜택을 우선시하세요. 잘 짜여진 단순한 트리거가 아무도 요구하지 않은 정교한 마이크로 세그먼트를 이깁니다. A/B 비교뿐만 아니라 홀드아웃 그룹을 활용해 측정하세요. 그렇지 않으면 의도를 영향력으로 오인하게 됩니다. 프라이버시를 묻어두지 말고 가시적으로 만드세요. 데이터 사용을 이해하는 고객은 개인화되는 것에 대해 나쁘지 않고 오히려 더 긍정적으로 반응하기 때문입니다.
이 모든 것의 기저에 깔린 공통된 실수는 순서의 문제에 있습니다. 팀들은 측정할 수 있기 전에 개인화를 먼저 시도하고, 타겟팅 모델을 이미 구축한 후에 동의를 요구합니다. 순서만 바로잡으면 나머지 대부분의 과정은 훨씬 쉬워집니다.
— 틸렌(Tilen)
대규모로 개인화를 운영하는 팀은 결국 똑같은 벽에 부딪힙니다. 의사결정 엔진은 올바른 메시지를 골라낼 수 있지만, 사람이 직접 작업하는 어떠한 콘텐츠 팀이라도 진정성 있게 읽히는 수백 가지의 변형, 제목, 온사이트 스니펫, 동적 상품 카피를 제작하는 일은 벅찰 수밖에 없습니다.
Semihuman.ai는 이 문제의 양쪽 측면 모두에 적합한 플랜을 제공합니다. 무료, 베이직, 프로 플랜은 마케팅 팀이 인터페이스를 통해 AI가 초안을 작성한 이메일 변형이나 랜딩 페이지 스니펫을 직접 휴머나이징(자연스럽게 다듬는)하는 데 적합합니다. 개발자, 비즈니스, 엔터프라이즈 플랜은 엔지니어링 팀에 API 액세스를 제공하여 기존 개인화 파이프라인 내부의 한 단계로서 휴머나이제이션을 실행할 수 있게 해주므로, 동적 콘텐츠가 고객에게 도달하기 전에 가독성 패스를 거치게 됩니다. AI 지원 콘텐츠 워크플로와 실제 유스케이스를 중심으로 구축된 도구에 대해 더 알아보고 싶다면, 악시오 네트웍스(Axio Networks)가 정리한 사례들을 자체 파일럿과 함께 살펴보시는 것을 추천합니다.
네, 추측이 아닌 자사 데이터와 실제 의사결정 로직을 기반으로 구축될 때 그렇습니다. 개인화를 훌륭하게 실행하는 기업들은 매출과 고객 반응에서 측정 가능한 성과를 거두며, 맥킨지는 선도 기업들 사이에서 10~15%의 매출 상승 효과가 있다고 보고합니다.
마케팅 소스에 따라 4D의 정의는 다양하며 단일 표준 프레임워크에 묶여 있지 않습니다. 연구 전반에 걸쳐 더 일관되게 인용되는 기반은 자사 데이터(First-party data), 의사결정(Decisioning), 모듈형 콘텐츠(Modular content), 그리고 측정(Measurement)이며, 이들은 대규모 개인화를 위한 실용적인 요구사항으로 함께 작동합니다.
맞춤형 참여란 모든 사람에게 일률적으로 보내는 일반적인 메시지가 아니라, 개별 고객의 행동, 선호도, 라이프사이클 단계에 맞춰진 상호작용을 의미합니다. 이는 특정 고객이 무엇을 필요로 하는지 예측하는 시스템에 의존하며, 닐슨 노먼 그룹은 이를 사용자가 수동으로 선호도를 설정하는 커스터마이제이션(Customization)과 구분합니다.
개인화는 모든 이에게 똑같은 방식을 적용하는 대신 고객이 입증한 행동에 콘텐츠, 제안, 타이밍을 맞춤으로써 불필요한 메시지를 줄이고 고객 경험을 향상시킵니다. Think with Google의 연구에 따르면, 자신의 데이터를 통제하고 있다고 느끼는 고객은 개인화되는 것에 대해 더 긍정적으로 반응하므로, 이는 가시적인 프라이버시 제어 기능과 결합될 때 가장 효과적으로 작동합니다.
가장 큰 리스크는 고객의 의도와 메시지의 실제 효과를 혼동하여 영향력을 과대평가하게 만드는 표준 A/B 테스트에만 의존해 개인화를 측정하는 것입니다. 전체 구매 주기에 걸쳐 홀드아웃 그룹을 운영하는 것이 개인화가 실제로 결과를 이끌어내고 있는지 정확하게 파악하는 방법입니다.