
Loading...
Een AI-schrijvingsdetector schat in hoe waarschijnlijk het is dat een tekst door een taalmodel is geproduceerd. Het bewijst niet wie het heeft geschreven. De praktische manier om zon tool te gebruiken, is door je concept erdoorheen te halen, de score te lezen als een signaal over patronen in je schrijfstijl, en vervolgens de gemarkeerde passages aan te passen totdat de tekst je eigen stem weerspiegelt. Semihuman is ontworpen voor die tweede helft: het detecteert door AI geschreven patronen in je tekst en maakt het menselijker, zodat de versie die je publiceert of indient leest alsof het door een mens is geschreven.
Een detector zoekt je tekst niet op in een database. Volgens het onderwijscentrum van de University of Kentucky schatten AI-detectors in of tekst geheel of gedeeltelijk is gegenereerd door een groot taalmodel door statistische patronen te analyseren, en in tegenstelling tot plagiaatdetectors vergelijken ze tekst niet met een bron. De uitvoer is een schatting, geen definitief oordeel.
Wat zijn die patronen dan? De HumTech-groep van UCLA noemt repetitieve of ongebruikelijke formuleringen, zinsbouw, toon en een gebrek aan persoonlijke nuance als veelvoorkomende signalen. Sommige systemen kwantificeren ook twee aspecten in het bijzonder:
Dat is nuttig om te weten, omdat het je vertelt wat je moet veranderen. Een score draait niet om de vraag of je hebt gejoemelen. Het is een meting van hoe uniform en voorspelbaar je proza is.
De meeste detectors werken op dezelfde manier en de onderstaande stappen zijn op elk van hen van toepassing.
Plak het volledige stuk erin. Korte fragmenten geven de tool te weinig om te meten, en scores op een paar zinnen schommelen meer dan scores op een volledig artikel. Als een tool een minimale lengte hanteert, behandel resultaten rond die minimumlengte dan met extra voorzichtigheid.
Voer de versie uit die je daadwerkelijk van plan bent te publiceren of in te dienen. Bewerkingen veranderen het patroon, dus een score die vóór je revisies is genomen, zegt weinig over het eindproduct.
Een score van 20% of 80% is geen meting van hoeveel van je tekst door een model is geschreven. Het bureau voor academische integriteit van de University of Melbourne raadt docenten aan om een volledig stuk werk te beoordelen in plaats van te vertrouwen op classificaties per zin. Dezelfde logica helpt jou als schrijver: kijk waar de markeringen zich clusteren in plaats van je blind te staren op één cijfer.
Markeringen laten zien welke zinnen de tool het meest machinaal vond. Zoek naar wat ze gemeen hebben. Typische boosdoeners zijn generieke openingszinnen, opeenstapelingen van overgangswororden, zinnen van gelijke lengte, definities die in elk artikel zouden kunnen verschijnen, en opsommingen van drie bijvoeglijke naamwoorden. Dit zijn precies de gewoontes waardoor concepten onnatuurlijk klinken, waar onze gids over waarom door AI geschreven essays onnatuurlijk klinken dieper op ingaat.
Bewerk de gemarkeerde passages en voer de controle dan opnieuw uit. Dit is het punt waarop de meeste mensen een uur verliezen. Handmatig zin voor zin herschrijven werkt, maar schiet niet op bij een artikel van 2.000 woorden. Semihuman neemt deze stap voor je uit handen: het herstructureert de tekst voor een natuurlijke leesbaarheid, en voor SEO-doeleinden kan het je trefwoorden integreren tijdens het herschrijven. Je kunt het resultaat vervolgens controleren voordat het ergens naartoe gaat.
Als je dezelfde paragraaf in twee detectors hebt geplakt en twee verschillende antwoorden hebt gekregen, is dat volkomen normaal. Het onderzoek hiernaar is consistent.
Een intercollegiaal getoetst (peer-reviewed) onderzoek testte 12 openbaar beschikbare tools en twee commerciële systemen en concludeerde dat de detectors over het geheel genomen noch nauwkeurig noch betrouwbaar waren, en dat het verhullen van de inhoud de prestaties aanzienlijk verslechterde.
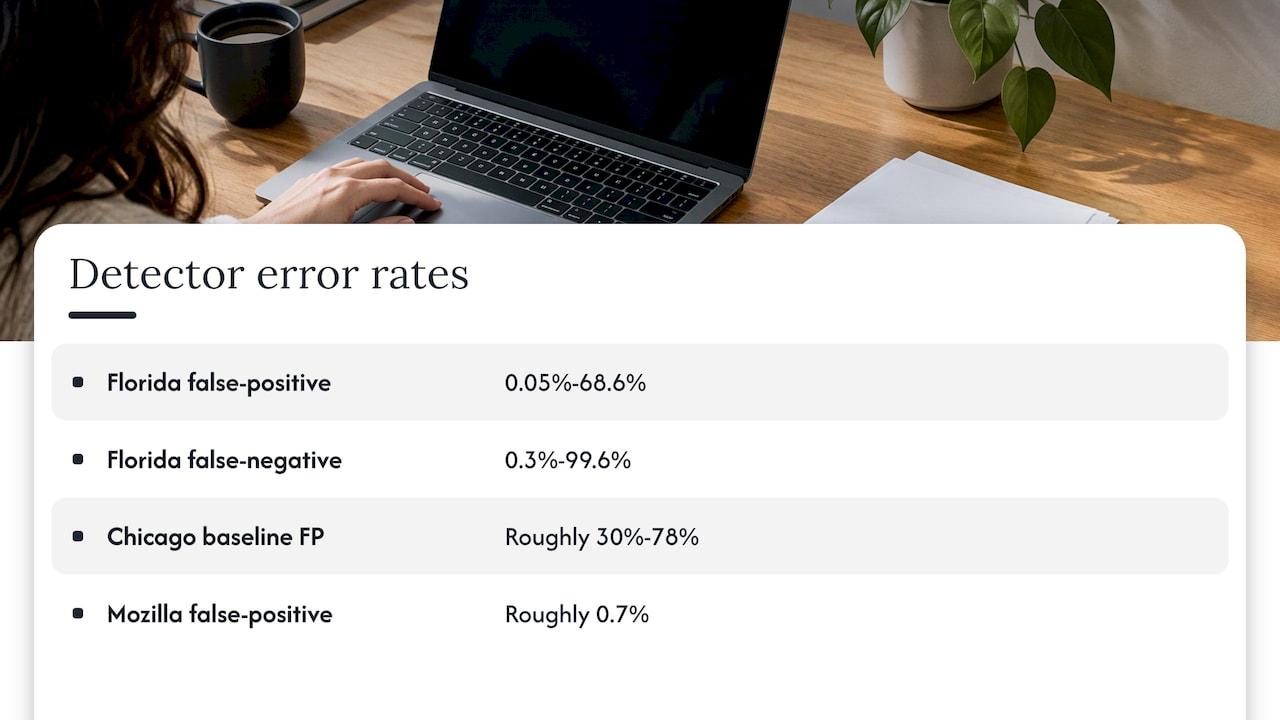
Een rapport van de University of Florida van mei 2026 beschrijft een onderzoek naar vijf populaire commerciële detectors. Het vond vals-positievenpercentages van 0,05% tot 68,6% en vals-negatievenpercentages van 0,3% tot 99,6% onder de testomstandigheden van het onderzoek. De onderzoekers vergeleken growweg 6.000 beveiligingsconferentiepapers van vóór ChatGPT met door taalmodellen gegenereerde versies van die papers.
Het Becker Friedman Institute van de University of Chicago rapporteert in een paper uit 2025 dat de prestaties aanzienlijk variëren per detector en testomstandigheid. De open-source baseline had vals-positievenpercentages van ruwweg 30% tot 78% in verschillende scenarios, en een streng plafond voor vals-positieven verminderde de detectie voor de meeste geteste tools.
Kleine percentages doen er ook toe. De evaluatie van de Mozilla Foundation uit 2024 rapporteerde een vals-positievenpercentage van ongeveer 0,7%, oftewel ongeveer één onterechte beschuldiging per 140 gevallen, naast een percentage juist-positieven van 43% voor de methode die zij evalueerden.
De belangrijkste les voor jou als schrijver: elke individuele score hangt af van welke tool je hebt gebruikt, hoe deze was afgesteld en wat voor soort tekst je erin hebt gevoerd. Dat is de reden waarom mensen die op grote schaal publiceren of werk inleveren hun tekst door meer dan één lens willen bekijken, en waarom een tool die is gebouwd om tekst aan te passen op basis van detectorpatronen nuttiger is dan een eenmalig cijfer.
Markeringen zijn niet beperkt tot ruwe chatbot-uitvoer. CELT van Kentucky opmerkt dat menselijke schrijfstijlen kunnen worden gemarkeerd omdat ze gebruikmaken van veelvoorkomende, voorspelbare of ongewijzigde formuleringen, en dat formulematige academische genres, standaardtactieken en standaardformuleringen het risico vergroten. Modellen zijn grotendeels getraind op menselijke teksten en geoptimaliseerd om deze te imiteren, waardoor de overlap groot is.
Lichte AI-hulp telt ook mee. Het ACL Findings-paper Almost AI, Almost Human uit 2025 ontdekte dat detectors door AI bijgeschaafde menselijke schrijfstijlen aanzien voor AI-tekst: één tool, GLTR, classificeerde 40,87% van de extreem licht bijgeschaafde en 42,81% van de licht bijgeschaafde GPT-4o-teksten als AI. Het door een grammaticabewerker halen van je eigen paragrafen kan dus de score veranderen, zelfs als elk idee volledig van jou afkomstig is.
Als je de lijst met triggers in detail wilt bekijken, zie dan waarom AI-inhoud wordt gemarkeerd. Kort samengevat zijn dit de patronen die een score verhogen:
| Patroon | Hoe het eruitziet | Wat te doen |
|---|---|---|
| Uniforme zinslengte | Elke zin telt 18 tot 22 woorden | Wissel zeer korte zinnen af met langere, gelaagde zinnen |
| Voorspelbare overgangen | Bovendien, Daarnaast, Verder achter elkaar | Snijd ze weg of gebruik het verband dat een echte lezer zou voelen |
| Generieke definities | X is een proces dat... | Vervang dit door een concreet voorbeeld uit je eigen werk |
| Gelijkmatig alinea-ritme | Dezelfde lengte, dezelfde vorm door het hele stuk | Laat een alinea uit één regel bestaan als het punt ook uit één regel bestaat |
| Geen direct bewijs of details | Beweringen zonder cijfers, namen of ervaring | Voeg een cijfer, een plaats of een resultaat toe dat je zelf hebt meegemaakt |
De routine is voor elke lezer van deze pagina hetzelfde; alleen de belangen verschillen.
Stap 5 is belangrijker dan het klinkt. Versiegeschiedenis, contouren en bronnotities zijn het bewijs dat laat zien hoe een stuk tot stand is gekomen, en het zijn de zaken waar een redacteur of docent om vraagt wanneer een score er vreemd uitziet. Onze gids over het creëren van een schrijfworkflow laat zien hoe je dit zo inricht dat het je vrijwel geen extra tijd kost.
Publiceren op schaal betekent dat dezelfde patronen zich herhalen over tientallen paginas, en uniforme tekst is precies het soort tekst dat een detector het gemakkelijkst markeert. Bouw de controle in als redactiestap, vlak vóór publicatie, en schrijf altijd eerst voor de lezer: onze handleiding over het humaniseren van AI-inhoud voor SEO behandelt dit uitgebreid. Als je wilt vergelijken hoe generatietools aansluiten bij een beoordelingsstap, dan laat dit overzicht van vergeleken AI-schrijftools de conceptzijde van het proces zien. Teams die de controle en het herschrijven direct willen koppelen aan hun eigen publicatiesysteem, kunnen de Semihuman API gebruiken.
Academisch proza is van nature formulematig: standaarddefinities, vaste sectiestructuren, behoedzame formuleringen. Dat is precies wat CELT van Kentucky en het integriteitsbureau van Melbourne identificeren als factoren die het risico op vals-positieven vergroten. De richtlijnen van Melbourne vragen medewerkers om de opdracht en de disciplinaire context te overwegen, evenals de vraag of de schrijfstijl van een student formulematig is. Je hebt geen controle over hoe jouw onderwijsinstelling een score leest, maar je hebt wel controle over de tekst. Schrijf je analyse in je eigen woorden, bewaar concepten en notities, en gebruik Semihuman om passages die als sjabloon overkomen glad te strijken. Onze lijst met signalen van door AI gegenereerde essays laat zien wat een beoordelaar als eerste opvalt.
Blijf rustig en werk het stapsgewijs af.
Als je een schrijver bent aan wie wordt gevraagd om een gemarkeerd stuk toe te lichten, vormen je concepten en notities het tweede bewijsstuk dat volgens de richtlijnen van Melbourne bij elk rapport moet worden gevoegd voordat er een beschuldiging wordt geuit: concepten, notities, eerder werk of een toelichting op het werk. Als je deze gereed hebt, verandert een stressvol gesprek in een kort gesprek.
Perspectief
We hebben Semihuman gebouwd omdat een score op zichzelf niemand helpt om een concept af te krijgen. Detectors vertellen je dat iets machinaal oogt; ze helpen je zelden om het op te lossen, en het onderzoek toont aan dat scores wild uiteen kunnen lopen van de ene tool tot de andere. Schrijvers hebben een tool nodig die daadwerkelijk met de tekst werkt.
Dat is waarom detectie en herschrijven in ons platform samenkomen. Je ziet waar de patronen zich bevinden, en dezelfde tool herstructureert de passage zodat deze op natuurlijke wijze leest, met behoud van jouw betekenis en je trefwoorden. Voor een blogger scheelt dit een avond werk. Voor een bureau betekent het dat elke pagina dezelfde stap doorloopt voordat deze wordt gepubliceerd. Voor een student betekent het dat het definitieve concept klinkt als de persoon die het heeft geschreven.
De webapp is geschikt voor individueel gebruik, en met de API kunnen teams dezelfde stap integreren in hun eigen systemen. Wij geloven dat de toekomst van door AI ondersteund schrijven ligt in concepten die door mensen worden gevormd, gecontroleerd en geclaimd, en daar bouwen wij voor.
Tilen
Semihuman is een webgebaseerde en via API toegankelijke tool die door AI gegenereerde tekst detecteert en humaniseert zodat deze authentiek geschreven oogt. Het herstructureert tekst voor een natuurlijke leesbaarheid, integreert trefwoorden voor SEO en is ontworpen om de patronen te neutraliseren waar detectors zoals Turnitin, GPTZero, Copyleaks en ZeroGPT op letten. Individuele abonnementen (Gratis, Basis en Pro) vind je op de prijzenpagina, en Developer-, Business- en Enterprise-abonnementen voor API-integratie staan op de API-toegangspagina.
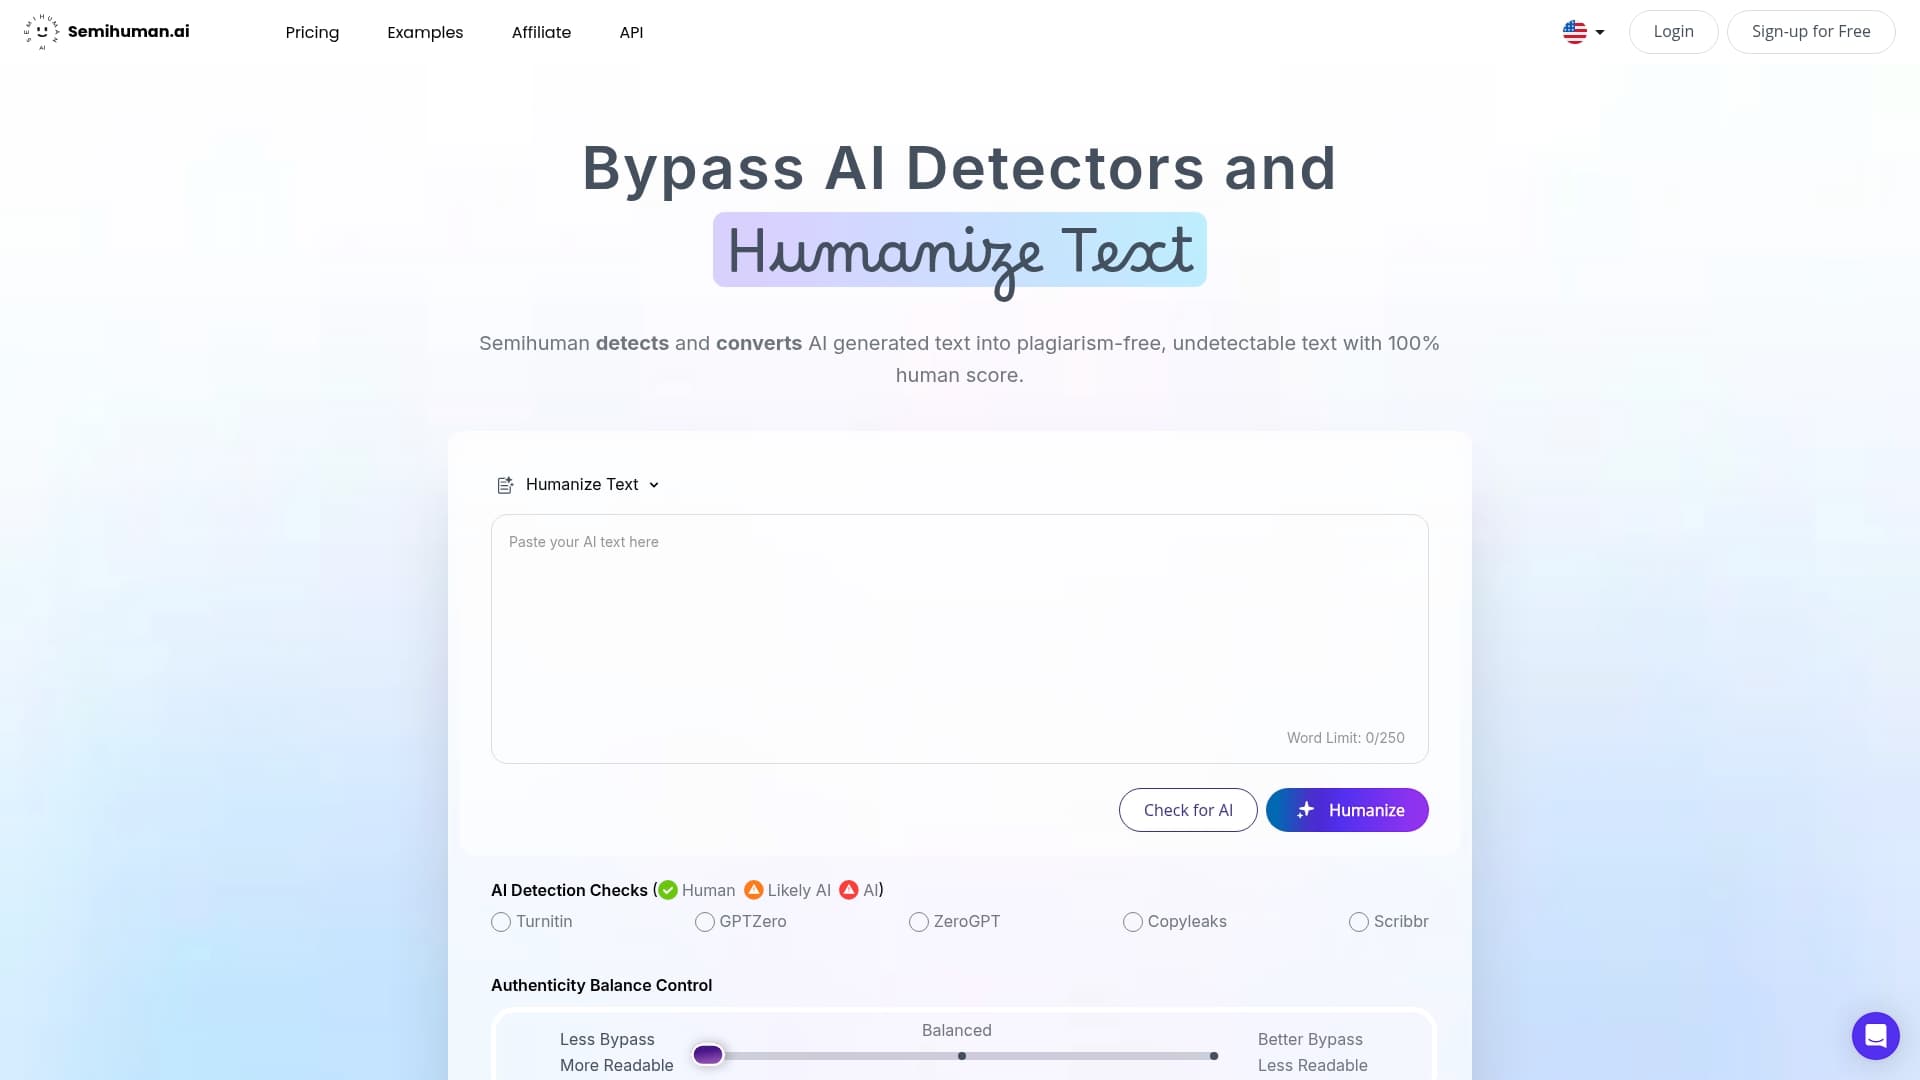
Je kunt ook beginnen vanaf de Semihuman homepage en je concept daarin plakken.
Of je nu redacteur, docent of opdrachtgever bent die de score van iemand anders leest, dezelfde regels zijn van toepassing en het is nuttig om ze te kennen, zelfs wanneer je zelf de schrijver bent.
Voor creators is de conclusie praktisch. Aangezien scores zo sterk variëren, is de veiligste positie om de tekst zelf zo te laten lezen dat deze menselijk overkomt: gevarieerd, specifiek en van jouzelf. Dat is een eigenschap van het schrijven die je kunt verbeteren, en dat is precies waar een humanizer voor dient. Als je verschillende benaderingen wilt vergelijken, bieden onze expertvergelijking van AI-inhoudhumanizers en de praktische voorbeelden van AI-detectietools meer detail.
Een paar aanpassingen doen meer dan welke instelling dan ook:
Een uitgewerkt voorbeeld. Een concept-introductie luidt: In het huidige digitale landschap is contentmarketing een krachtige strategie die bedrijven kunnen inzetten om groei te realiseren. Elk woord is voorspelbaar en de zin zegt eigenlijk niets. Herschreven: Onze blog leverde vorig kwartaal 40 aanmeldingen op, voornamelijk dankzij twee artikelen over prijzen. De tweede versie bevat een cijfer, een feit dat alleen jij weet en een onregelmatig ritme. Detectors hebben hier veel minder in te markeren, en een lezer haalt er veel meer uit.
Nee. Een plagiaatcontrole vergelijkt je tekst met bestaande bronnen. Een AI-schrijvingsdetector analyseert statistische patronen om in te schatten of een model de tekst heeft gegenereerd, en wijst geen specifieke bron aan. Een stuk kan hoog scoren op de ene en laag op de andere.
Dat hangt af van de tool en de test. Een rapport van de University of Florida in mei 2026 vond vals-positievenpercentages van 0,05% tot 68,6% bij vijf commerciële detectors onder de geteste omstandigheden. Beschouw elke individuele score als een schatting en bekijk in plaats daarvan de gemarkeerde passages.
Ja. Voorspelbare, formulematige of standaardteksten kunnen worden gemarkeerd, evenals menselijke teksten die licht zijn bijgeschaafd met AI. Het toevoegen van specifieke details, het variëren van zinnen en het bewaren van je concepten en notities beschermt je hiertegen.
Herschrijf de gemarkeerde passages met je eigen voorbeelden, cijfers en een gevarieerd ritme, en controleer het daarna opnieuw. Semihuman voert deze herstructurering voor je uit en kan tegelijkertijd trefwoorden integreren voor SEO. Je kunt beginnen met het gratis abonnement of overstappen naar een betaald abonnement op de prijzenpagina.
Ja. Semihuman biedt een API met Developer-, Business- en Enterprise-abonnementen, vermeld op de API-toegangspagina, zodat teams deze stap binnen hun eigen workflow kunnen laten uitvoeren.
Start
Humaniseren
gratis!
Menselijker maken