
Loading...
Hanteer deze volgorde: verwerk eerst regels in de prompt, herschrijf de alineas die door een detector worden gemarkeerd, voer vervolgens één volledige humanize-ronde (menselijker maken) uit over het hele document en sluit af met een controle op specifieke details. Direct naar een paraphraser (herschrijftool) grijpen, verlaagt de detectiescores zelden. De promptfase voorkomt de meeste typische AI-kenmerken voordat ze überhaupt ontstaan, en tools zoals Semihuman.ai regelen de humanize-ronde en de eindcontrole. Een succesvol resultaat betekent een lagere detectorscore, vlottere teksten en geen verlies van feitelijke informatie.
Kort samengevat (TL;DR):
- Herstructureren draait om het aanpassen van zinslengtes, het variëren van de zinsopbouw en het verwijderen van dooddoeners. Dit verlaagt AI-detectiescores veel effectiever dan simpelweg synoniemen vervangen.
- Het toevoegen van specifieke details, cijfers en observaties vanuit de ik-persoon tijdens het herstructureren, vergroot de authenticiteit en de betrokkenheid van de lezer.
- Het gebruik van regels op promptniveau – zoals verboden woorden, zinslengtes en stijlbeperkingen – levert natuurlijkere resultaten op dan alleen achteraf redigeren.
- Een effectieve workflow bestaat doorgaans uit het opnieuw genereren van content met ingebouwde regels, het herschrijven van gemarkeerde secties, het menselijker maken van de volledige tekst en tot slot een feitencontrole vóór publicatie.
- Snelle bewerkingen van 30 minuten omvatten het opschonen van verboden woorden, het variëren van zinnen en het toevoegen van echte voorbeelden of observaties om de authenticiteit te verhogen en detectie te voorkomen.
De meeste mensen pakken het herstructureren van AI-teksten verkeerd aan. Ze openen een paraphraser, halen de hele tekst er één keer doorheen en vinden het wel best. Dat werkt zelden, omdat het simpelweg vervangen van synoniemen niets verandert aan de échte signalen waar detectoren op letten: eenvormige zinnen, signaalwoorden zoals bovendien die om de drie regels opduiken, en een verdacht gelijkmatig ritme. Structurele herschrijvingen (waarbij je de bron daadwerkelijk sluit en het idee in je eigen woorden reconstrueert) verlagen detectiescores op een manier die het vervangen van synoniemen niet kan.
De meest effectieve stappen, in ruwe volgorde van impact:
De volgorde is hierbij belangrijk, omdat detectoren en lezers op verschillende lagen reageren. Detectoren markeren statistische patronen. Lezers letten op toon en specificiteit. Door verboden woorden al op promptniveau aan te pakken, voorkom je beide problemen tegelijkertijd. Daarom mag dit nooit de laatste stap zijn.
Pro Tip: Lees je conceptversie eerst hardop voor voordat je iets anders doet. Als je over een zin struikelt of halverwege buiten adem raakt, zal het perplexiteitsmodel van een detector deze waarschijnlijk ook markeren.
De prompt is de plek waar het meeste humaniseringswerk zou moeten plaatsvinden, niet de redactiefase. Het afdwingen van structuur tijdens het genereren werkt beter dan proberen het achteraf te maskeren. Het model volgt expliciete instructies namelijk betrouwbaarder op dan dat het reageert op herschrijvingen achteraf.
Een goed werkend prompt-template heeft vier blokken nodig:
Dit werkt omdat handhaving op promptniveau verandert wat het model genereert, terwijl parafraseren alleen verandert wat al bestaat. Uit een analyse bleek dat regels op promptniveau de latere redactielast aanzienlijk verminderen door AI-kenmerken te voorkomen in plaats van ze te maskeren. Dat is precies de logica achter het als eerste uitvoeren van deze stap.
Pro Tip: Plak je lijst met verboden woorden in elke prompt als een vaste instructie, niet als een eenmalige opmerking. Modellen vallen binnen een paar alineas terug op hun standaardformuleringen als je de beperking niet herhaalt.
Vier stappen, in deze exacte volgorde, werken beter dan welke eenmalige methode dan ook.
De geschatte tijd voor het herstructureren van een gemiddeld artikel omvat een paar minuten voor het opnieuw genereren, ongeveer een kwartier voor gericht herschrijven, zon tien minuten voor de humanize-ronde, en de tijd voor de feitencontrole varieert afhankelijk van de inhoud. Dat laatste is de stap die mensen vaak afraffelen, terwijl juist die stap je geloofwaardigheid beschermt.
Stop met aanpassen zodra:
Workflows die uitsluitend op een paraphraser leunen, zonder deze structurele volgorde, laten detectiescores vaak grotendeels ongewijzigd. Dit is het sterkste argument om de bovenstaande volgorde aan te houden in plaats van direct door te springen naar stap drie.
Je hebt niet altijd tijd voor de volledige workflow. Als je deadline al over een uur is, loop dan deze verkorte checklist af:
Statistiek om in de gaten te houden: het gelijktijdig aanpakken van meerdere signalen levert een duurzamere verlaging van detectiescores op dan het isoleren van één enkel probleem. Alleen het opschonen van verboden woorden is niet genoeg als je zinslengtes nog steeds uniform zijn.
Drie benaderingen dekken de meeste praktijksituaties tijdens het redigeren, en ze sluiten elkaar niet uit.
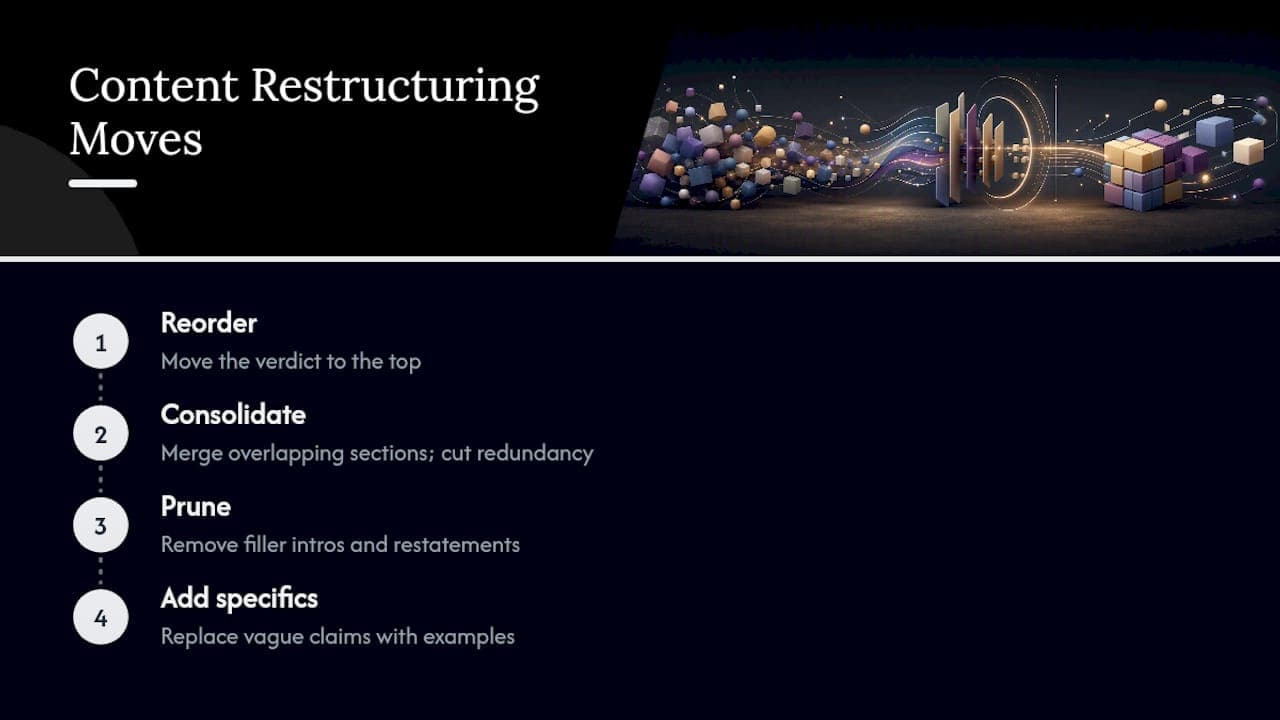
Herschikken verplaatst bestaande content naar een andere volgorde zonder de woorden veel te veranderen. Dit is belangrijk wanneer een AI-concept het antwoord verstopt in alinea vier in plaats van alinea één. Dit gebeurt voortdurend, omdat modellen de neiging hebben om naar een conclusie toe te werken in plaats van ermee te beginnen. Verplaats de kernboodschap naar boven en schuif de ondersteunende details naar beneden.
Samenvoegen combineert overlappende secties die twee keer hetzelfde zeggen in net iets andere bewoordingen – nog zon typische AI-gewoonte. Als je concept een sectie heeft over voordelen en een andere over pluspunten die elkaar herhalen, voeg ze dan samen en schrap de overbodige tekst volledig.
Snoeien verwijdert secties die de tekst wel langer maken, maar geen waarde toevoegen: langdradige inleidingen, herhaalde conclusies of algemene opvulalineas die op elk willekeurig onderwerp van toepassing kunnen zijn. AI-concepten krikken op deze manier vaak het aantal woorden op, vooral in inleidingen en afsluitingen.
Een vierde, minder besproken stap is het toevoegen van specifieke details tijdens het herstructureren: terwijl je herschikt of snoeit, vervang je vage beweringen door concrete details. Als een alinea stelt dat veel bedrijven resultaten hebben geboekt en je bent die zin toch al aan het bewerken, dan is dat hét moment om een echt voorbeeld toe te voegen of de zin in zijn geheel te schrappen. Door dit tegelijk met structurele wijzigingen te doen, in plaats van als een aparte ronde, bespaar je tijd en pak je meer van dit soort gevallen aan.
Herstructureren is logisch wanneer het onderliggende onderzoek en de feiten kloppen, maar de presentatie mechanisch leest. Helemaal opnieuw schrijven is zinvoller wanneer de inhoud feitelijk mager is of de argumentatie rammelt. Geen enkele bewerking op zinsniveau kan een zwak uitgangspunt redden.
Drie vragen bepalen welke weg je moet inslaan:
Ligt de detectorscore dicht bij een voldoende of juist ver weg? Als een detector 60% van een document markeert als waarschijnlijk door AI gegenereerd, is gericht herschrijven van de gemarkeerde secties plus een humanize-ronde meestal genoeg om het gat te dichten. Als de score 95% is, heeft het concept waarschijnlijk een structurele herbouw nodig, geen simpele pleister.
Beantwoordt het stuk de vraag van de lezer al? Als de kerninformatie nuttig is, maar weggestopt of repetitief, ga dan herstructureren. Als het stuk om de hete brij heen draait zonder een duidelijk antwoord te geven, is dat een inhoudelijk probleem dat je met herstructureren niet oplost.
Hoeveel tijd heb je in verhouding tot de belangen? Een scriptie van een student die door een plagiaatscanner en een academische integriteitscommissie gaat, vereist een veel grondigere herstructurering dan een marketing-e-mail die simpelweg wat minder robotachtig moet klinken voordat hij wordt verzonden. Stem je inspanning af op wat er daadwerkelijk op het spel staat.
Het duidelijkste teken dat herstructureren voldoende is: een moedertaalspreker die de tekst één keer leest, valt over onhandige formuleringen, maar niet over verwarrende logica. Het duidelijkste teken dat je opnieuw moet schrijven: de lezer moet een alinea herlezen om te begrijpen wat er precies wordt beweerd.
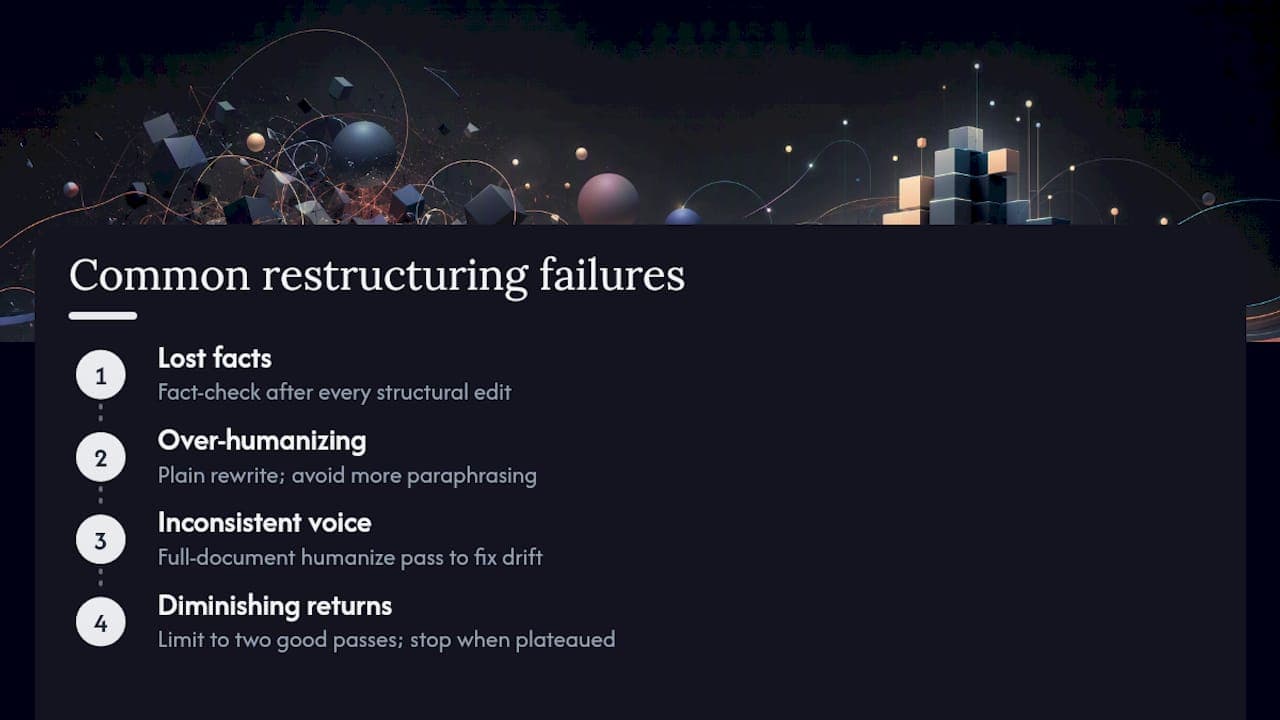
De meest gemaakte fout is het verliezen van feiten tijdens de jacht op een beter ritme. Redacteuren korten een zin in om de eentonigheid te doorbreken en schrappen per ongeluk net dat ene getal dat de alinea geloofwaardig maakte. De oplossing is simpel, maar wordt onder deadlinedruk makkelijk overgeslagen: voer na elke structurele bewerking een feitencontrole uit, niet alleen één keer aan het eind.
De tweede fout is de tekst zó menselijk proberen te maken dat deze onsamenhangend wordt. Agressief herschrijven om detectorpatronen te vermijden, kan leiden tot grammaticaal vreemde zinnen of het weglaten van overgangen die een lezer juist nodig heeft om de logica te volgen. Als een alinea na het redigeren ongemakkelijk leest, is dat geen detectorprobleem meer, maar een leesbaarheidsprobleem. Dan is een gewone herschrijving nodig, geen extra parafrasering.
Een derde uitdaging is een inconsistente schrijfstijl in een document dat in stukjes is geredigeerd. Als je gemarkeerde alineas afzonderlijk herschrijft zonder het hele stuk achteraf opnieuw te lezen, worden toonwisselingen overduidelijk: formeel in de ene sectie, informeel in de volgende. Dit is precies waarom de humanize-ronde over het volledige document zo belangrijk is in de redactionele workflow: het is de stap die de verschuivingen in toon opvangt die je bij een alinea-voor-alinea-aanpak mist.
De vierde uitdaging is de wet van de verminderde meeropbrengst. Teams voeren soms wel vijf of zes humanize-rondes uit in de jacht op een perfecte detectorscore. Elke extra ronde vergroot echter het risico op nieuwe fouten of het strippen van de overgebleven persoonlijkheid uit de tekst. Twee goed uitgevoerde rondes zijn beter dan zes krampachtige pogingen. Als de score niet meer verandert en een moedertaalspreker de overgangen niet kan opmerken, stop dan.
De detectorscore is de meest voor de hand liggende maatstaf, maar zeker niet de enige die ertoe doet. Een document kan goed scoren op een detector en toch slecht lezen. Dat schiet zijn doel voorbij als je streeft naar oprechte waarde voor de lezer in plaats van alleen maar door een filter komen.
Houd drie dingen naast elkaar bij: de detectorscore voor en na, een leesbaarheidsscore (zoals Flesch-Kincaid of vergelijkbaar), en een subjectieve hardop-leestest waarbij je je afvraagt of een buitenstaander zou raden dat dit met behulp van AI is geschreven. Blindstaren op het detectorcijfer is minder waardevol dan het vergroten van oprechte originaliteit en lezerswaarde. Een goed proces verbetert alle drie de statistieken tegelijk, niet alleen degene die het makkelijkst te automatiseren is.
Betrokkenheidssignalen (engagement) laten langer op zich wachten, maar zijn op de lange termijn belangrijker. De tijd op de pagina, scrolldiepte en de kwaliteit van reacties verbeteren doorgaans wanneer herstructurering échte specificiteit toevoegt, in plaats van alleen maar de zinsopbouw te husselen. Een alinea met een oprecht voorbeeld houdt de aandacht langer vast dan een alinea met algemene opvultekst, ongeacht hoe deze scoort op een detector.
Als je content herstructureert voor betere zoekprestaties in plaats van alleen om detectie te omzeilen, combineer de humanize-ronde dan met een analyse van hoe gemenselijkte content de SEO-resultaten beïnvloedt. Zoekmachines en AI-detectoren reageren namelijk soms op overlappende, maar niet identieke signalen. Een document dat voor een mens natuurlijk leest, presteert meestal op beide fronten beter, maar het is de moeite waard om dit te controleren in plaats van er zomaar van uit te gaan.
Een marketingteam dat wekelijks een blogpost publiceerde, merkte dat hun door AI geschreven artikelen steeds werden gemarkeerd door zowel hun interne plagiaatscanner als hun publiek. Lezers lieten reacties achter dat de content niet helemaal klopte, zonder precies te kunnen benoemen waarom. De oplossing was geen groter budget voor herschrijven. De oplossing was het verplaatsen van de verboden woorden en de regels voor zinsvariatie naar de promptfase, waardoor de eerste versie veel minder correctie nodig had. De herschrijf-en-humanize-volgorde op de overgebleven gemarkeerde alineas dichtte vervolgens het grootste deel van het gat.
Een academische schrijfcontext vertelt een vergelijkbaar verhaal. Een student die AI-tools gebruikte voor het samenvatten van onderzoeken, liep herhaaldelijk tegen waarschuwingen van plagiaatsoftware aan. Niet omdat de content was gekopieerd, maar omdat de formuleringspatronen te veel leken op bekende AI-output, wat argwaan wekte. Het herstructureren van de gemarkeerde alineas met oprechte redeneringen vanuit de ik-persoon – waarbij werd uitgelegd wáárom een bron belangrijk was in plaats van deze alleen maar samen te vatten – loste de waarschuwingen op. De redenering zelf werd namelijk veel moeilijker in een template te vangen.
Professionele redacteuren gebruiken hiervoor al heel lang een soort anker-techniek: een uniek specifiek detail, een daadwerkelijk eigen cijfer, een oprecht detail of een echte observatie die geen enkele detector of paraphraser kan reproduceren, simpelweg omdat het nergens anders bestaat om te kopiëren. Dat is de rode draad in beide bovenstaande voorbeelden. De teams die succes boekten, herschikten niet alleen zinnen. Ze voegden iets toe wat een template niet zelfstandig kon genereren.
De meeste gidsen behandelen detectiescores als de eindstreep. Dat zijn ze niet. Een document kan perfect als menselijk scoren en toch volkomen zielloos lezen. De teams die de beste resultaten behalen, behandelen de detectorscore als een symptoom, niet als de ziekte. Als je proza algemeen is en je zinnen eenvormig zijn, scoor je slecht op detectoren én lukt het je niet om de aandacht van de lezer vast te houden. Beide problemen komen namelijk voort uit dezelfde oorzaak: een gebrek aan specificiteit.
De keerzijde die niemand graag toegeeft: agressief en gehaast humaniseren introduceert soms grammaticale eigenaardigheden of stript een belangrijk feit uit de tekst. Automatisering is uitstekend in het herstellen van ritme en formuleringspatronen. Het is echter niet betrouwbaar in het bepalen welk getal in je document cruciaal is. Die inschatting vereist nog steeds een mens, elke keer weer, voordat er iets wordt gepubliceerd.
Waar automatisering echt zijn plek verdient, is de mechanische laag: zinsvariatie, het handhaven van verboden woorden en het tellen van gedachtestreepjes. Waar het tekortschiet, is in beoordelingsvermogen. Gebruik het voor het eerste, en sla nooit een menselijke controle over voor het tweede.
— Tilen
Semihuman.ai sluit direct aan op stap drie en vier van de bovenstaande workflow: de humanize-ronde over het volledige document en de definitieve verificatiecheck. In plaats van handmatig te zoeken naar verboden woorden, uniforme zinslengtes en overgebleven gedachtestreepjes in een lang concept, past de tool herstructurering en zoekwoordintegratie toe in één enkele ronde. Vervolgens krijg je een document dat klaar is voor een laatste feitencontrole, in plaats van wéér een ronde handmatige tekstcorrecties.
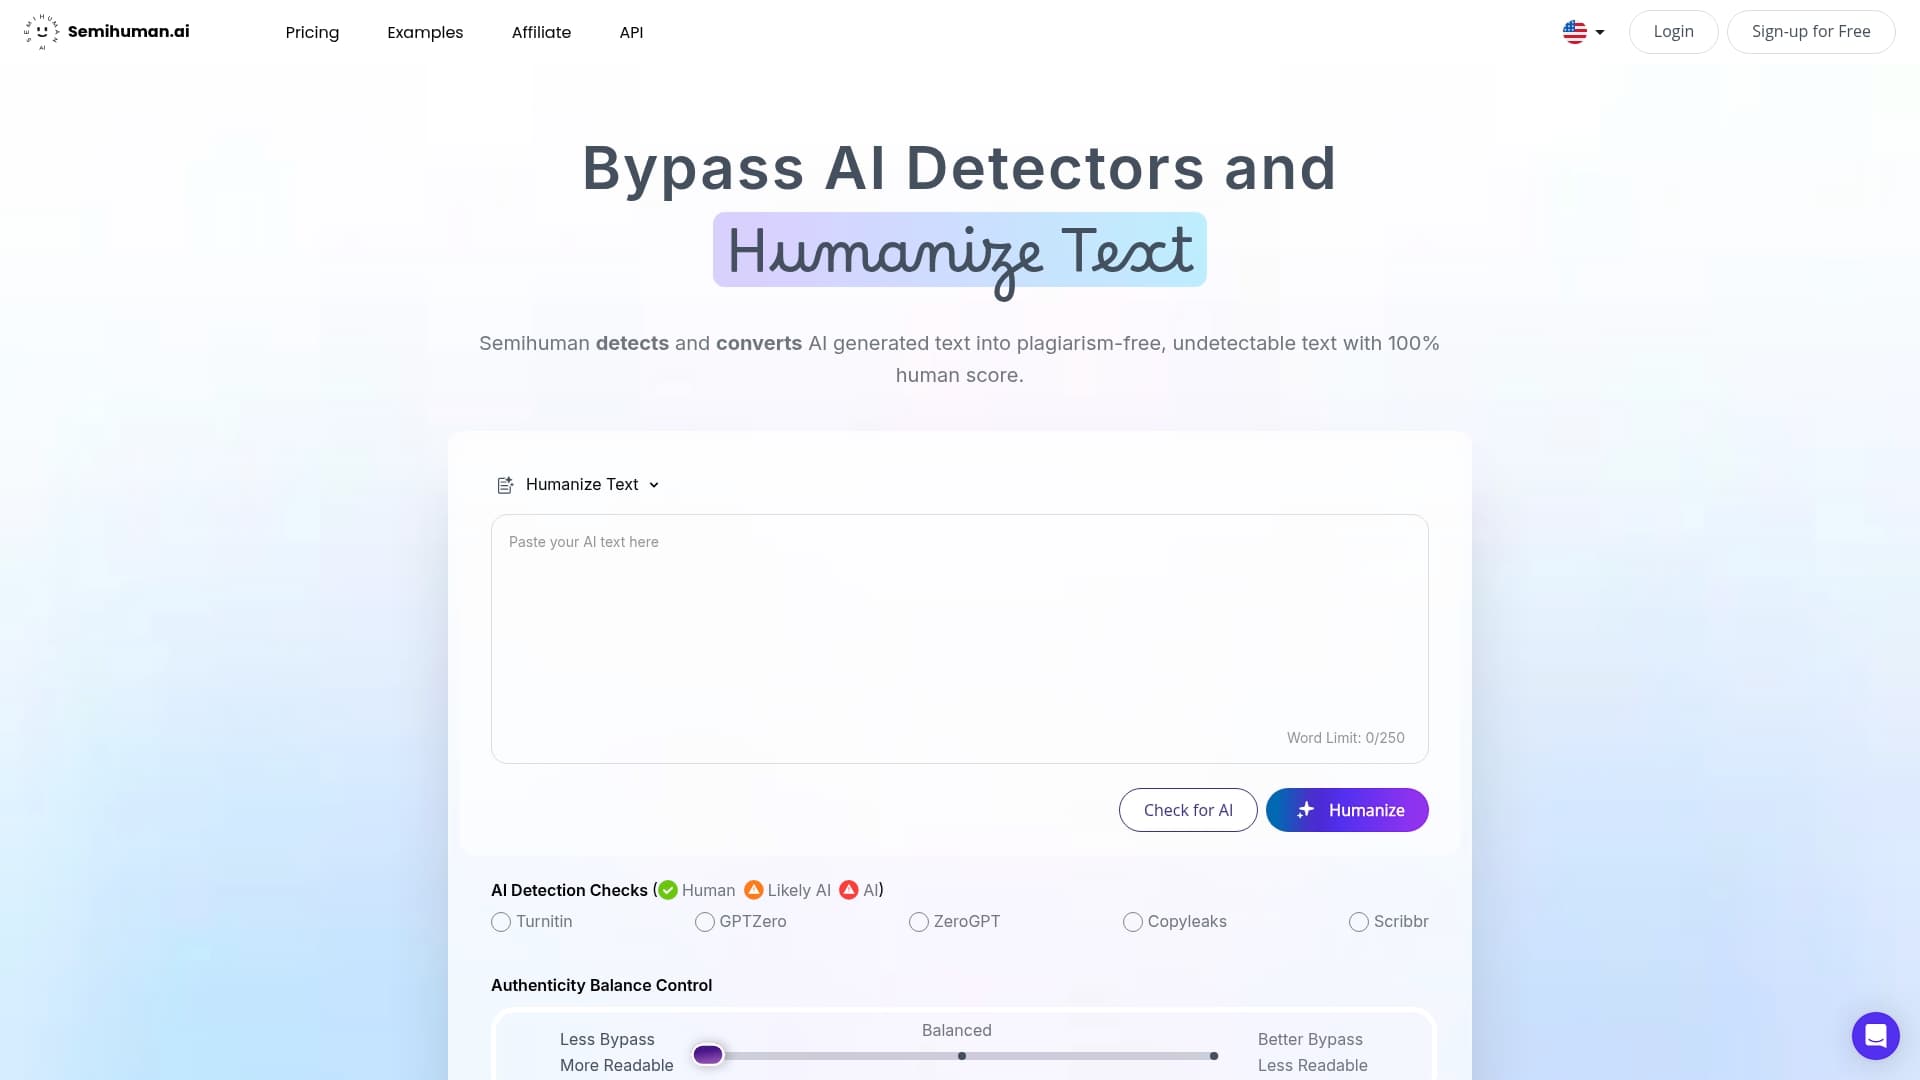
Het platform werkt via een webinterface voor eenmalige documenten, of via een API voor teams die dit proces op grote schaal uitvoeren – zoals marketingbureaus die concepten van klanten redigeren, SEO-teams die regelmatig content verwerken, of studenten die een scriptie controleren voor het inleveren. Beide routes passen dezelfde herstructureringslogica toe: AI-patronen detecteren, de zinsopbouw herbouwen en doelzoekwoorden integreren zonder ongemakkelijke handmatige toevoegingen onder deadlinedruk.
Als je je in de parafraseerfase van de workflow bevindt, pakt de AI text paraphraser specifiek de herschrijvingen van gemarkeerde alineas aan. Als je dichter bij publicatie bent en een laatste detectorcheck nodig hebt, dekt AI-proof writing die verificatiestap. Voor de volledige herstructurerings- en zoekwoordronde zoals hierboven beschreven, begin je met de SEO-tekstgenerator en haal je je volgende concept erdoorheen voordat je publiceert.
De Postibo-gids over het menselijker maken van AI-content ondersteunt de regels op promptniveau en het advies over burstiness (zinsvariatie) in dit stuk. De analyse van OutrightCRM over parafraseren versus humaniseren onderbouwt de aanbeveling voor de workflow in twee stappen. De gids van Eyesift over het herschrijven van AI-tekst diende als basis voor het advies over hardop voorlezen en het verankeren vanuit de ik-persoon. Het artikel van HubSpot over AI-contenthumanisering vormt de basis voor de ethische en transparantiepunten in de perspectiefsectie. Voor een bredere strategische context over AI in contentplanning, zie dit overzicht van de rol van AI in contentstrategie.
Gebruik Zoeken en vervangen voor je lijst met verboden woorden, beperk het aantal gedachtestreepjes en voeg variatie in zinslengte toe. Dit is allemaal te doen in minder dan 30 minuten, zonder de tekst volledig opnieuw te hoeven schrijven.
Niet op een betrouwbare manier. Aanpakken die uitsluitend op een paraphraser leunen, laten detectiescores vaak grotendeels ongewijzigd, omdat ze alleen woorden vervangen zonder de zinsopbouw of het ritme te veranderen.
Allebei, maar regels op promptniveau moeten op de eerste plaats komen. Het inbouwen van verboden woorden en regels voor zinsvariatie in de prompt vermindert detectormarkeringen veel effectiever dan ze achteraf te moeten oplossen.
Nee. Tools zijn goed in mechanische herstructurering, zinsvariatie, zoekwoordintegratie en het handhaven van verboden woorden. Voor feitencontroles en inschattingen over wat behouden moet blijven, is echter nog steeds een menselijke blik nodig.
De geschatte tijd voor het herstructureren van een gemiddeld artikel omvat een paar minuten voor het opnieuw genereren, ongeveer een kwartier voor gericht herschrijven, zon tien minuten voor de humanize-ronde, en de tijd voor de feitencontrole varieert afhankelijk van de inhoud.
Start
Humaniseren
gratis!
Menselijker maken