
Loading...
Beschouw AI als een junior schrijver: het produceert snel een concept, maar het heeft een menselijke redacteur nodig om dat concept om te vormen tot iets dat klinkt alsof het door één specifiek persoon is geschreven. De betrouwbare weg loopt via een menselijk geleid redactieproces in twee fasen: een strategische ronde gevolgd door een humaniserende redactieronde, getoetst aan detector- en parafraseeronderzoek in plaats van giswerk. Tools zoals Semihuman passen in die tweede fase en helpen je om het resultaat te verifiëren en te verfijnen voordat het de deur uitgaat.
TL;DR:
- Menselijke redactie moet zich voornamelijk richten op het verifiëren van feiten, het afstemmen van het concept op je merkstem en het herstructureren van de inhoud voor helderheid en impact.
- Het herschikken van alineas om te beginnen met specifieke voorbeelden of claims in plaats van definities versterkt het natuurlijke, spreekwoordelijke ritme van het schrijven.
- Het ontwikkelen van een herkenbare stem vereist een bewuste variatie in zislengte, concreet woordgebruik, herhaalde zinnen en opzettelijke imperfectie, waarbij overmatige redactie wordt vermeden.
- Het combineren van AI-detectietools en een menselijke beoordeling biedt een betrouwbaardere manier om door AI gegenereerde concepten te identificeren en te verbeteren, aangezien geen enkele methode waterdicht is.
- Het aanpassen van inhoud voor verschillende doelgroepen of indelingen vereist dat de kern-stemelementen behouden blijven, terwijl taal en structuur worden aangepast, wat effectief wordt bevestigd door te lezen op herkenning.
Voordat je aan de stijl op zinsniveau begint, doorloop je een korte reeks die de grootste problemen als eerste aanpakt. Direct beginnen met het wisselen van woorden is tijdverspilling als het concept nog de verkeerde invalshoek heeft of een niet-gecontroleerd feit bevat.
Deze volgorde is belangrijk. Een alinea kan op zinsniveau prachtig lezen en toch het stuk onderuithalen als het het verkeerde punt beargumenteert of opent met dezelfde inleidende opmerking waar elk AI-model standaard mee begint. Los eerst de structuur en inhoud op, dan de stem en als laatste de verificatie.
De strategische redactie en de zinsredactie lossen verschillende problemen op, en het door elkaar halen daarvan is de reden waarom zoveel gehumaniseerde concepten nog steeds lezen als een machine in een trenchcoat. Het Content Marketing Institute raadt aan om AI te behandelen als een instrument, of een junior schrijver, en deze te voeden met documentatie over de merkstem voordat je een redactie in twee fasen toepast om een onderscheidend resultaat te creëren.
De strategische redactie komt op de eerste plaats en behandelt de inhoud van het stuk:
De zinsredactie komt op de tweede plaats en behandelt alles wat een lezer ervaart in plaats van opsomt:
Door de AI vooraf te voorzien van een kort document over de merkstem, voorbeeldalineas en een lijst met wel/niet-aanraders, hoef je achterin minder te corrigeren, omdat het concept dichter bij jouw register begint. Het Content Marketing Institute wijst ook op een nuttige gewoonte: een bewuste pauze tussen generatie en redactie, waarin je elke alinea kritisch bekijkt in plaats van deze bij de eerste lezing te accepteren. Richtlijnen voor het opbouwen van herbruikbare stemvoorbeelden voor AI-prompts kunnen dit herhaalbaar maken voor een heel team, in plaats van afhankelijk te zijn van het geheugen van één redacteur.
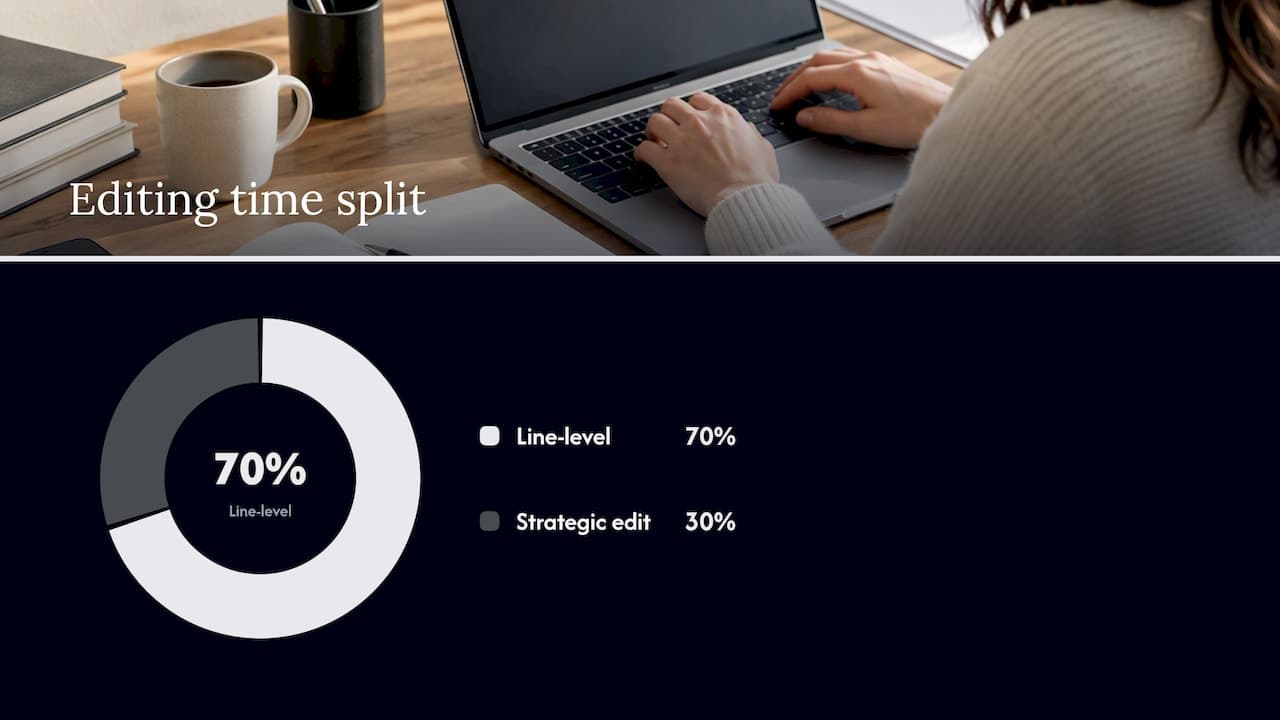
Een werkbare verdeling voor de meeste teams is ongeveer 30% van de redactietijd aan strategie en 70% aan menselijke correcties op zinsniveau, waarbij een senior redacteur of vakkundige de strategische ronde afhandelt en een schrijver die vertrouwd is met de merkstem de zinsredactie doet.
Pro-tip: Houd een doorlopend document bij met zinnen, ritmes en uitdrukkingen die uniek zijn voor jouw stem of merk, en plak dit elke keer in je AI-prompt, zodat het eerste concept minder correctie nodig heeft.
Structuur is de eerste hefboom en degene die redacteuren het vaakst overslaan. AI-concepten openen doorgaans met een definitie, gaan door drie even zware punten en sluiten af met een samenvattende alinea die alles herhaalt wat zojuist is gezegd. Herschik dit: begin met het meest specifieke of verrassende punt, schrap de herhaalde conclusie volledig en schrijf een openingszin op basis van een echt detail in plaats van een categorische stelling.
Cadans doet meer werk dan de meeste redacteuren verwachten. Een reeks AI-zinnen heeft vaak een lengte van twaalf tot twintig woorden per stuk, gelijkmatig getemporiseerd, zonder afgebroken zinnen en zonder retorische vragen. Door dat patroon te breken — een zin van vier woorden na een lange zin, af en toe een vraag die naar de lezer wordt gegooid, een zin die begint met En of Maar — klinkt de tekst gesproken in plaats van geassembleerd.
Lexicale specificiteit onderscheidt een menselijke stem van een competente samenvatting. Veel bedrijven gebruiken tools om de efficiëntie te verbeteren zegt niets; Marketingteams voeren hun concepten door Grammarly voor grammatica en Hemingway Editor voor helderheid voordat een mens ze zelfs maar aanraakt zegt iets wat een lezer zich kan voorstellen. Vervang abstracte zelfstandige naamwoorden door benoemde tools, zintuiglijke details of nichetermen die specifiek zijn voor het vakgebied waarin je schrijft.
Kenmerkende markeringen bouwen na verloop van tijd herkenbaarheid op. Een schrijver of merk dat consistent teruggrijpt naar dezelfde soort metafoor, argumenten op dezelfde manier opent of terugkeert naar een bepaalde zin, wordt over verschillende stukken heen identificeerbaar alsof er een byline (auteursvermelding) bij staat, zelfs als die er niet is.
Overmatig polijsten is een weggevertje op zich. Een concept met nul onvolledige zinnen, nul contracties en een volkomen parallelle structuur leest als gefabriceerd, juist omdat echt schrijven dat zelden bereikt. Het bekijken van voorbeelden van gehumaniseerde tekst naast hun AI-originelen maakt dit gat concreet in plaats van theoretisch.
Detectors vangen veel op, maar niet alles, en een schone scan behandelen als bewijs van kwaliteit is een vergissing. Uit de NIST GenAI Text-to-Text pilotstudie bleek dat detectors vaak AI kunnen onderscheiden van door mensen geschreven tekst, maar de prestaties variëren per modelpaar, en sommige generatoren kunnen een bepaalde discriminator bedriegen terwijl andere consistent worden gepakt. Die variabiliteit is de reden waarom de slaagt-melding van een enkel gereedschap niet het einde van het proces is.
Parafraseeronderzoek voegt een tweede laag toe. Bevindingen uit ACLs PASTED-onderzoek tonen aan dat parafraseren de statistische signalen waarop detectors vertrouwen kan verschuiven, en dat parafrase-detectiemodellen herschreven passages nog steeds met sterke nauwkeurigheid kunnen identificeren wanneer de parafrase en het origineel qua structuur dicht bij elkaar blijven. In de praktijk betekent dit dat licht parafraseren op zichzelf een zwakke humaniseringsstrategie is in vergelijking met echte structurele en lexicale herbewerking.
Een pragmatische volgorde werkt beter dan te vertrouwen op een enkel controlemiddel:
Als een detector een passage markeert, is de oplossing zelden nog een ronde synoniemen verwisselen. Pas de structuur opnieuw aan, voeg een specifiek voorbeeld toe dat alleen iemand met directe kennis zou opnemen, of haal een expert op het vakgebied erbij om de bewering te verscherpen. The Associated Press behandelt AI-output als ongecontroleerd bronmateriaal dat menselijke beoordeling en verificatie vereist voordat er iets wordt gepubliceerd, wat een nuttige standaard is om je eigen proces aan te meten, ongeacht je branche.
Een schrijfstem is in deze context de consistente set van structurele, lexicale en ritmische keuzes die een stuk inhoud herkenbaar maken als afkomstig van een specifiek persoon of merk, zelfs zonder auteursvermelding. Het komt tot uiting in welke woorden je kiest, hoe lang je zinnen gemiddeld zijn, wat je weglaat en de kleine gewoontes die lezers over meerdere stukken heen beginnen te herkennen.
Dit is om drie praktische redenen van belang. Ten eerste leest generieke AI-output identiek aan duizenden andere generieke AI-concepten over hetzelfde onderwerp, wat lezers en zoekmachines geen enkele reden geeft om jouw versie te verkiezen. Ten tweede bouwt een herkenbare stem na verloop van tijd vertrouwen op, net zoals een bekende byline dat doet: lezers komen terug omdat ze weten wat ze krijgen. Ten derde fungeert een onderscheidende stem in toenemende mate als proxy voor authenticiteit, aangezien zowel lezers als geautomatiseerde systemen generieke, overdreven gladde tekst behandelen als een teken van weinig inspanning.
Het doel van de hierboven beschreven workflow in twee fasen is niet om te verhullen dat AI bij het opstellen betrokken was. Het is om ervoor te zorgen dat het gepubliceerde stuk het werkelijke menselijke oordeel, specifieke kennis en een consistent standpunt weerspiegelt: de dingen waar een lezer daadwerkelijk naar op zoek is wanneer hij ervoor kiest om door te lezen na de eerste alinea.
Voordat je AI-concepten kunt bewerken naar jouw stem, moet je een helder beeld hebben van hoe die stem daadwerkelijk klinkt. Een paar oefeningen maken dat concreet in plaats van abstract.
Schrijf dezelfde korte alinea op drie manieren: als een sms-bericht naar een vriend, als een formele memo en in je natuurlijke publicatiestem. Door de drie te vergelijken ontdek je welke gewoontes echt van jou zijn en welke geleende formaliteit zijn die je niet nodig hebt.
Verzamel vijf stukken die je hebt geschreven en die een sterke reactie kregen, positief of kritisch, en markeer elke zin die duidelijk klinkt zoals jij in plaats van als generiek proza. Patronen komen meestal snel naar voren: een neiging tot korte stellende zinnen, de gewoonte om met een vraag te openen, een voorkeur voor concrete voorbeelden boven abstracties.
Houd een lopende lijst bij van woorden en zinnen die je jezelf ziet vermijden of overmatig ziet gebruiken. Beide vertellen je iets: vermeden woorden komen vaak niet overeen met je register, en overmatig gebruikte woorden zijn vroege kenmerkende markeringen die je bewust moet behouden in plaats van ze weg te redigeren.
Herschrijf ten slotte een week lang elke dag één door AI gegenereerd alinea zonder hulp van enig hulpmiddel, en zet er een timer op van minder dan vijf minuten. Snelheid dwingt instinct af bovenoverleg, wat de echte stem doorgaans sneller naar boven brengt dan een langzame, zorgvuldige herschrijving.
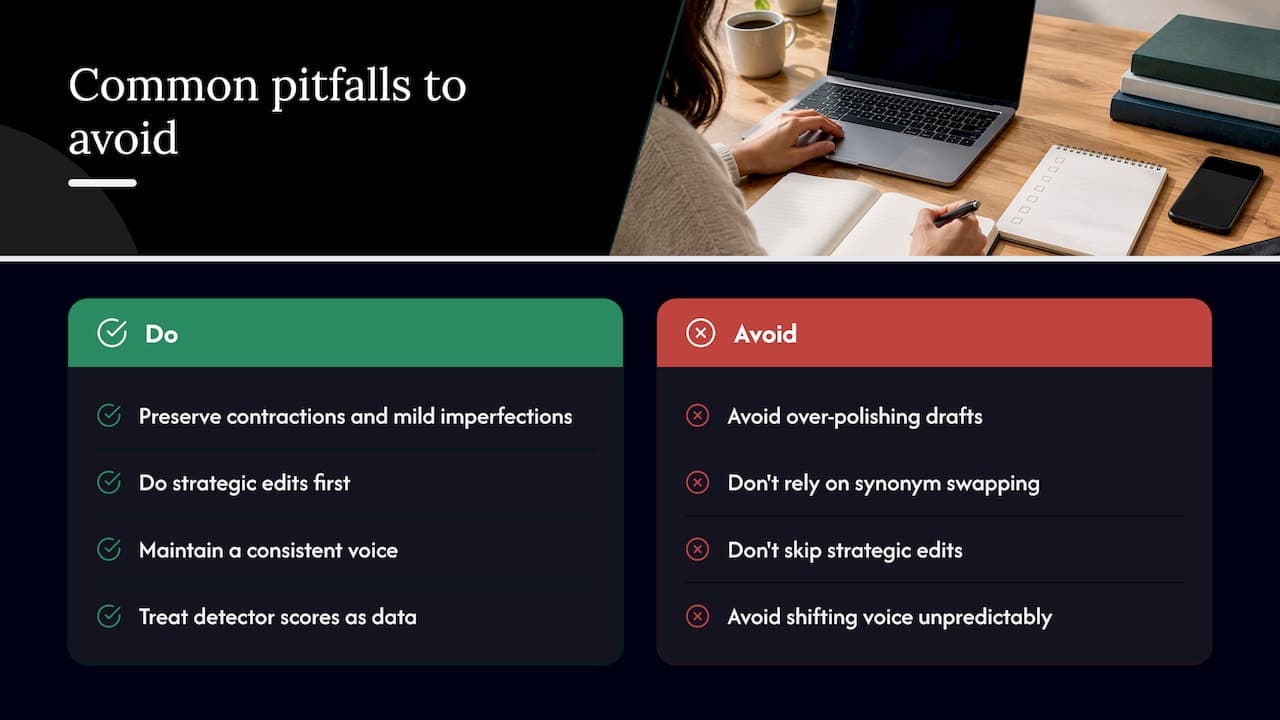
De meest gemaakte fout is overmatig polijsten. Redacteuren die op zoek zijn naar een schoon concept verwijderen vaak elk fragment, elke contractie en elke milde imperfectie, wat proza oplevert dat technisch correct is en precies leest als de AI-output waarmee het begon.
Een tweede valkuil is het vertrouwen op synoniemwisselingen als humaniseringsstrategie. Het een dozijn keren vervangen van gebruiken door inzetten verandert de woordenschat zonder de structuur, het ritme of de inhoud te veranderen, en onderzoek naar parafrase-detectie toont aan dat dat soort oppervlakkige herschrijving vaak nog steeds herkenbaar is omdat de onderliggende zinsvormen hetzelfde blijven, zoals de bevindingen van ACL over parafrase-detectie suggereren.
Een derde is het volledig overslaan van de strategische redactie en direct overstappen op de stijl op zinsniveau. Een prachtig verwoord alinea dat het verkeerde punt beargumenteert of een onverifëerd feit stelt, faalt ongeacht hoe natuurlijk de zinnen klinken.
Een vierde is inconsistentie: het gebruik van een scherpe, informele stem in het ene stuk en een stijve, zakelijke stem in het volgende. Lezers en merkdoelgroepen bouwen vertrouwen op door herhaling, en een stem die onvoorspelbaar verschuift leest als onbetrouwbaar in plaats van veelzijdig.
Tot slot: het behandelen van een enkele AI-detector-scan als definitief bewijs van kwaliteit negeert wat de NIST-pilotstudie daadwerkelijk vond: de prestaties van detectors variëren per combinatie, dus één schone score is een datapunt, geen garantie.
Een technische blogpost met een eigen stem leunt vaak op precieze, specifieke zelfstandige naamwoorden en korte stellende zinnen, waarbij ontwijkende woorden worden geschrapt en bevindingen eenvoudig worden gesteld. De stem komt naar voren in wat het weigert te over-uitleggen, in de overtuiging dat de lezer kan meekomen.
Een marketing-e-mail met een sterke stem leest meestal conversationeel, dichter bij hoe de schrijver daadwerkelijk praat, met contracties, korte alineas en af en toe een directe aanspraak die persoonlijk aanvoelt in plaats van als een sjabloon.
Academisch of onderzoeksgerelateerd schrijven ontwikkelt een stem door de argumentatiestructuur in plaats van informaliteit: de manier waarop een schrijver een tegenargument kadert voordat het wordt ontmanteld, of terugkeert naar hetzelfde kaderingsmechanisme in een paper, wordt herkenbaar, zelfs binnen een formeel register.
Verhalend of journalistiek schrijven brengt de stem vaak over door middel van pacing en de selectie van details, waarbij één levendig, specifiek voorbeeld wordt gekozen boven drie generieke, en door middel van zinsritme dat nabootst hoe de schrijver het verhaal hardop zou vertellen.
In alle vier is de rode draad terughoudendheid: een onderscheidende stem komt meestal voort uit wat een schrijver consequent kiest op te nemen, te schrappen of te benadrukken, niet uit opsmuk die bovenop generieke proza wordt aangebracht.
Een consistente stem betekent niet overal identieke output. Het betekent een herkenbare kern die aan de randen buigt afhankelijk van de opmaak en het publiek.
Houd voor een technisch publiek je kernzinsritme en kenmerkende formulering aan, maar versmal de woordenschat naar precieze, vakspecifieke termen en schrap elke terzijde die het argument niet dient. Voor een algemeen consumentenpubliek kan dezelfde stem losser worden: kortere zinnen, concretere analogieën, minder gespecialiseerde termen.
De indeling is net zo belangrijk als het publiek. Een social media-bericht gebouwd op basis van een lang artikel moet de cadans van de stem en een kenmerkende zin of twee behouden, maar de structurele steigers laten vallen, aangezien een lange opbouw die werkt in een artikel als opvulling leest in drie zinnen. Een e-mail heeft meer directe aanspraak nodig dan een blogpost, omdat de lezer verwacht dat hij wordt aangesproken in plaats van op afstand te worden geïnformeerd.
De praktische test: lees het aangepaste stuk naast het origineel. Als een lezer die jouw werk kent het nog steeds als het jouwe zou herkennen ondanks de formatwijziging, is de aanpassing geslaagd. Als het leest alsof een ander persoon het heeft geschreven, is de aanpassing te ver gegaan en zijn de kenmerkende elementen weggeslagen die de stem in de eerste plaats identificeerbaar maken.
AI produceert snel concepten, maar oordeelsvermogen blijft mensenwerk, en de redacteuren die de bovenstaande twee fasen behandelen als een checklist in plaats van een formaliteit eindigen met een aanzienlijk betere, betrouwbaardere output. We hebben de workflow in dit stuk rondom die overtuiging gebouwd: eerst strategie, dan stem, altijd verificatie. Semihuman bestaat specifiek om de zinsredactie- en verificatiefasen te ondersteunen, en biedt redacteuren een praktische manier om een concept te humaniseren en te controleren voordat het wordt gepubliceerd.
— Tilen
Het handmatig doorlopen van de bovenstaande workflow werkt, maar het gaat langzamer dan nodig is wanneer je inhoud produceert op volume. Semihuman detecteert AI-patronen in een concept, herstructureert en humaniseert de tekst zodat deze natuurlijk leest, en integreert onderweg trefwoorden, wat een groot deel van de zinsredactie- en verificatiefasen in één keer dekt.
Als individuele schrijver of klein team dekken de Free-, Basic- en Pro-abonnementen de meeste workflows. Als je humanisering moet integreren in een grotere contentpipeline, bieden de Developer-, Business- en Enterprise-opties je API-toegang om het proces binnen je hele team te automatiseren.
Geen enkele detector pakt alles consistent op. Uit de NIST GenAI Text-to-Text pilotstudie bleek dat detectors in veel gevallen menselijke content van AI kunnen onderscheiden, maar dat de prestaties variëren, dus het combineren van een detectorscan met menselijke beoordeling geeft een betrouwbaardere meting dan te vertrouwen op één enkel instrument.
Normen voor openbaarmaking variëren per publicatie en branche, maar The Associated Press behandelt AI-output als ongecontroleerd materiaal dat vóór publicatie menselijke verificatie behoeft, wat een redelijke basislijn is, zelfs buiten de journalistiek. Raadpleeg het redactionele beleid van je eigen organisatie voor de specifieke norm die op jou van toepassing is.
Parafraseren verschuift enkele statistische signalen die detectors gebruiken, maar onderzoek van ACLs PASTED-onderzoek toont aan dat parafrase-detectiemodellen geparafraseerde passages met hoge nauwkeurigheid kunnen identificeren wanneer parafrases qua structuur dicht bij elkaar blijven. Structurele en lexicale herbewerking, in plaats van eenvoudige synoniemen verwisselen, is de duurzamere aanpak.
Sterk gesjabloneerde AI-output of zeer technische onderwerpen hebben wellicht meer strategische tijd nodig voordat de zinsredactie überhaupt begint.
Lees het hardop voor. Zinnen die allemaal dezelfde lengte hebben, contracties missen of afsluiten met een keurige, herhaalde samenvatting zijn de duidelijkste weggevertjes, en een korte detector- en menselijke beoordeling achteraf bevestigt wat je oor al had opgepikt.
Start
Humaniseren
gratis!
Menselijker maken