
Loading...
Preverjalnik umetne inteligence ocenjuje, kako verjetno je, da je besedilo ustvaril jezikovni model. Ne dokazuje pa, kdo ga je dejansko napisal. Najboljši način za uporabo takšnega orodja je, da vanj vnesete osnutek, rezultat obravnavate kot kazalnik vzorcev v svojem pisanju in nato označene odlomke preoblikujete, da bo besedilo zvenelo v vašem lastnem glasu. Orodje Semihuman je zasnovano ravno za ta drugi del: v vašem besedilu zazna vzorce, ki jih je ustvarila umetna inteligenca, in ga naredi bolj človeškega, tako da je končna različica, ki jo objavite ali oddate, videti, kot bi jo napisal človek.
Preverjalnik vašega besedila ne išče v podatkovni bazi. Po ugotovitvah izobraževalnega centra Univerze v Kentuckyju detektorji umetne inteligence ocenjujejo, ali je besedilo v celoti ali delno ustvaril velik jezikovni model, in sicer z analizo statističnih vzorcev, pri čemer v nasprotju s preverjalniki plagiatorstva besedila ne primerjajo z virom. Rezultat je ocena in ne pravnomočna sodba.
Kaj so ti vzorci? Skupina HumTech na univerzi UCLA navaja ponavljajoče se ali nenavadne fraze, strukturo povedi, ton in pomanjkanje osebnih nians kot pogoste signale. Nekateri sistemi merijo tudi dve specifični značilnosti:
To je koristno vedeti, ker vam pove, kaj morate spremeniti. Rezultat ne pomeni, da ste »goljufali«, temveč prikazuje, kako enolično in predvidljivo je vaše besedilo.
Večina preverjalnikov deluje na enak način, spodnji koraki pa veljajo za domala vsakega od njih.
Prilepite celotno besedilo. Kratki odlomki orodju ne ponujajo dovolj gradiva za merjenje, ocene na podlagi nekaj povedi pa nihajo precej bolj kot ocene za celoten članek. Če ima orodje minimalno dolžino, rezultate v bližini te meje obravnavajte s še večjo previdnostjo.
Preverite tisto različico, ki jo dejansko nameravate objaviti ali oddati. Ureditve spremenijo vzorec, zato ocena, pridobljena pred vašimi popravki, pove zelo malo o končnem delu.
Ocena 20 % ali 80 % ni merilo za to, kolikšen del vašega besedila je napisal model. Urad za akademsko integriteto Univerze v Melbournu osebju svetuje, naj pregleda celotno delo namesto zanašanja na klasifikacije odlomka za odlomkom. Enaka logika pomaga tudi vam kot piscu: preverite, kje so opozorila najgostejša, namesto da se osredotočate na eno samo število.
Oznake pokažejo, katere povedi so se orodju zdele najbolj strojne. Bodite pozorni na to, kaj je skupno tem povedim. Tipični krivci so splošni uvodi, nakopičeni prehodni členi, enako dolge povedi, definicije, ki bi se lahko pojavile v katerem koli članku, in seznami treh pridevnikov. To so natanko tiste navade, zaradi katerih osnutki zvenijo nenaravno, kar podrobno obravnava naš vodnik zakaj eseji, napisani z umetno inteligenco, zvenijo nenaravno.
Uredite označene odlomke in ponovno zaženite preverjanje. Tukaj večina ljudi izgubi uro časa. Ročno prepisovanje poved za povedjo deluje, vendar je pri članku z 2,000 besedami prepočasno. Semihuman ta korak opravi namesto vas: preoblikuje besedilo za naravno berljivost, pri SEO delu pa lahko med prepisovanjem vključi tudi vaše ključne besede. Rezultat nato preverite, preden gre kdor koli drug pogledat.
Če ste isti odstavek prilepili v dva različna preverjalnika in dobili dva različna odgovora, je to povsem normalno. Raziskave so si o tem enotne.
V recenzirani študiji so preizkusili 12 javno dostopnih orodij in dva komercialna sistema ter sklenili, da detektorji na splošno niso bili ne natančni ne zanesljivi in da je zakrivanje vsebine njihovo delovanje občutno poslabšalo.
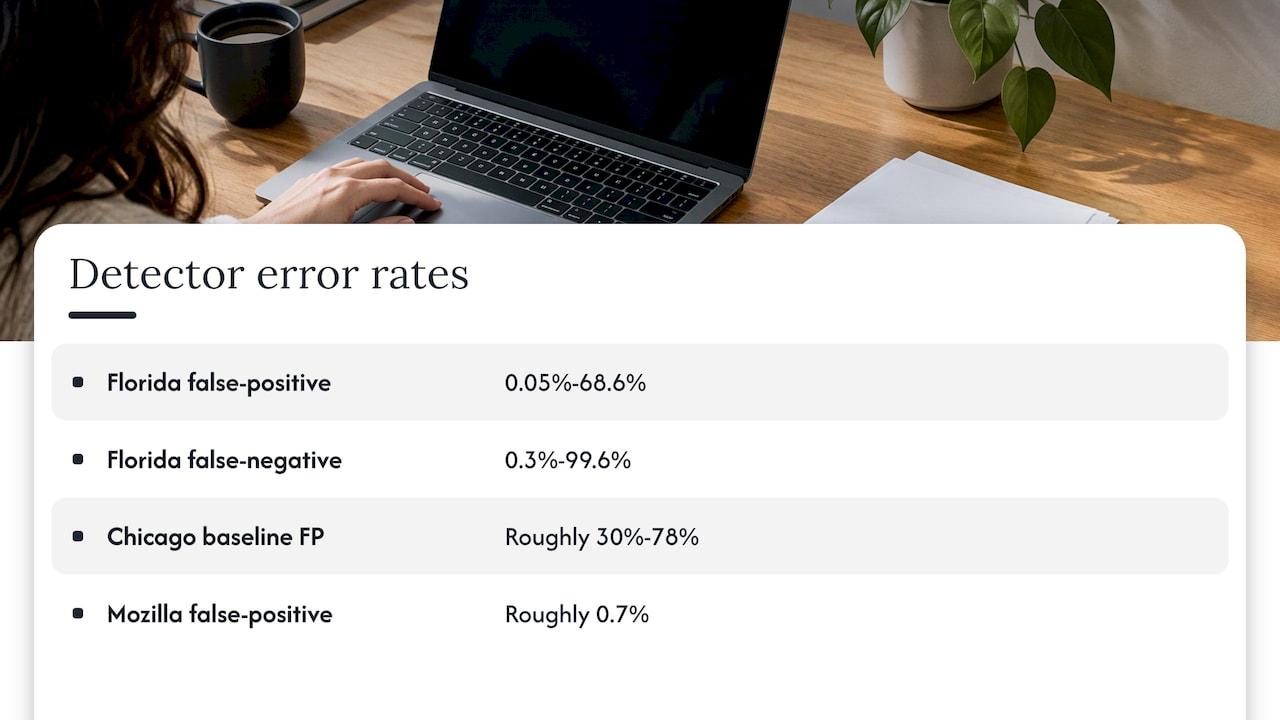
Poročilo Univerze na Floridi iz maja 2026 opisuje študijo petih priljubljenih komercialnih detektorjev. Pod pogoji študije je ugotovilo stopnjo lažno pozitivnih rezultatov od 0,05 % do 68,6 % in stopnjo lažno negativnih rezultatov od 0,3 % do 99,6 %. Raziskovalci so primerjali približno 6.000 varnostnih konferenčnih prispevkov, nastalih pred obdobjem ChatGPT-ja, z različicami teh prispevkov, ki jih je ustvaril jezikovni model.
Inštitut Becker Friedman pri Univerzi v Chicagu v prispevku iz leta 2025 poroča, da se učinkovitost bistveno razlikuje glede na detektor in pogoje testiranja. Njegovo odprtokodno izhodišče je imelo v različnih scenarijih približno 30- do 78-odstotno stopnjo lažno pozitivnih rezultatov, stroga omejitev lažno pozitivnih rezultatov pa je pri večini testiranih orodij zmanjšala sposobnost zaznavanja.
Majhni odstotki so prav tako pomembni. Ocena fundacije Mozilla Foundation iz leta 2024 je pokazala približno 0,7-odstotno stopnjo lažno pozitivnih rezultatov – kar pomeni približno eno napačno obtožbo na 140 primerov – ob 43-odstotni stopnji lažno pozitivnih rezultatov za ocenjeno metodo.
Glavni nauk za vas kot pisca je: vsak posamezen rezultat je odvisen od tega, katero orodje ste uporabili, kako je bilo nastavljeno in kakšno besedilo ste mu vnesli. Zato ljudje, ki objavljajo ali oddajajo večje količine besedil, želijo svoje delo pogledati skozi več različnih optik in zato je orodje, ustvarjeno za preoblikovanje besedila glede na vzorce detektorjev, precej uporabnejše od enokratne številke.
Opozorila niso omejena le na surove izpise klepetalnih botov. Center CELT Univerze v Kentuckyju opozarja, da je človeško pisanje lahko označeno, ker uporablja pogoste, predvidljive ali neraznolike fraze ter da tveganje povečujejo formulaične akademske zvrsti, standardne definicije in ustaljeni obrazci. Modeli so usposobljeni predvsem na človeškem pisanju in optimizirani za njegovo posnemanje, zato je prekrivanje obsežno.
Šteje tudi manjša pomoč umetne inteligence. Prispevek z lanske konference ACL z naslovom »Skoraj umetna inteligenca, skoraj človek« je pokazal, da detektorji človeško pisanje, ki ga je umetna inteligenca le rahlo izpopolnila, zamenjujejo za besedilo umetne inteligence: eno od orodij, GLTR, je kot umetno inteligenco označilo 40,87 % besedil, ki jih je GPT-4o zelo rahlo izpopolnil, in 42,81 % tistih, ki jih je izpopolnil v manjši meri. Zato lahko vnos vaših lastnih odstavkov v slovničnega pomočnika spremeni rezultat, čeprav je vsaka ideja vaša.
Če vas podrobno zanima seznam sprožilcev, si oglejte zakaj je vsebina, ustvarjena z umetno inteligenco, označena. Na kratko, vzorci, ki povišajo rezultat, so:
| Vzorec | Kako je videti | Kaj storiti |
|---|---|---|
| Enotna dolžina povedi | Vsaka poved ima 18 do 22 besed | Združite zelo kratke povedi z daljšimi, večplastnimi |
| Predvidljivi prehodi | »Poleg tega«, »Nadalje«, »V nadaljevanju« v zaporedju | Odstranite jih ali uporabite povezavo, ki bi jo začutil pravi bralec |
| Splošne definicije | »X je proces, ki...« | Nadomestite s konkretnim primerom iz vašega dela |
| Enakomeren ritem odstavkov | Enaka dolžina, enaka oblika skozi celotno besedilo | Pustite, da je odstavek dolg le eno vrstico, ko je bistvo v eni vrstici |
| Brez prvovrstnih podrobnosti | Trditve brez številk, imen ali izkušenj | Dodajte številko, kraj ali rezultat, ki ste ga dejansko videli |
Postopek je enak za vsakega bralca te strani; razlikujejo se le vložki.
Peti korak je pomembnejši, kot se zdi. Zgodovina različic, osnutki in zapiski o virih so dokaz, ki prikazuje, kako je besedilo nastalo, in to je tisto, kar urednik ali mentor zahteva, ko se vam rezultat zdi nenavaden. Naš vodnik za ustvarjanje delovnega toka pisanja prikazuje, kako si ga lahko uredite, da vas skorajda ne stane dodatnega časa.
Objavljanje večjih količin pomeni, da se isti vzorci ponavljajo na ducatih strani, enotno besedilo pa najlažje opazijo detektorji. Vključite preverjanje v uredniški korak, neposredno pred objavo, in pišite najprej za bralca: naš vodnik o človeškem prilagajanju vsebine AI za SEO obravnava prav to. Če primerjate, kako se orodja za ustvarjanje vključujejo v korak pregledovanja, vam pregled primerjave pisnih orodij z umetno inteligenco predstavljajo vidik priprave osnutkov. Ekipe, ki želijo imeti preverjanje in prepisovanje vdelana v lastni sistem objave, lahko uporabljajo vmesnik API Semihuman.
Akademsko pisanje je po naravi formulaično: standardne definicije, ustaljene strukture poglavij, previdna ograjenost z izjavami. Točno to center CELT Univerze v Kentuckyju in urad za integriteto v Melbournu opredeljujeta kot dejavnike, ki povečujejo tveganje lažno pozitivnih rezultatov. Melbournske smernice osebju naročajo, naj upošteva kontekst naloge in stroke ter ali je študentovo pisanje formulaično. Ne morete vplivati na to, kako vaša ustanova bere oceno, lahko pa vplivate na besedilo. Svojo analizo napišite z lastnimi besedami, hranite osnutke in zapiske ter uporabite Semihuman, da zgladite odlomke, ki delujejo šablonsko. Naš seznam znakov esejev, ustvarjenih z umetno inteligenco, prikazuje, kaj pregledovalec opazi najprej.
Ostanite mirni in težavo odpravite po vrsti.
Če ste pisec, od katerega se zahteva pojasnilo označenega prispevka, so vaši osnutki in zapiski tisti drugi dokaz, ki ga melbournske smernice omenjajo kot obvezen del vsakega poročila pred obtožbo: osnutki, zapiski, prejšnje delo ali pojasnilo o delu. Če jih imate pripravljene, se stresen pogovor spremeni v kratkega.
Perspektiva
Orodje Semihuman smo ustvarili zato, ker ocena sama po sebi nikomur ne pomaga dokončati osnutka. Preverjalniki vam povedo, da je nekaj videti strojno narejeno; le redko pa vam pomagajo to popraviti, poleg tega pa raziskave kažejo, da se ocene med posameznimi orodji lahko divje razlikujejo. Pisci potrebujejo orodje, ki deluje neposredno na besedilu.
Zato sta zaznavanje in prepisovanje v naši platformi združena. Vidite, kje so vzorci, isto orodje pa preoblikuje odlomek tako, da zveni naravno, pri čemer ostanejo vaš pomen in vaše ključne besede nedotaknjeni. Za blogerja to prihrani cel večer. Za agencijo to pomeni, da gre vsaka stran skozi enak korak, preden je objavljena. Za študenta pa to pomeni, da končni osnutek zveni tako, kot ga je napisal tisti, ki stoji za njim.
Spletna aplikacija pokriva posamično uporabo, vmesnik API pa ekipam omogoča, da enak korak vnesejo v lastne sisteme. Menimo, da je prihodnost pisanja s pomočjo umetne inteligence v osnutkih, ki jih ljudje oblikujejo, preverjajo in imajo v lasti, in prav za to ustvarjamo rešitve.
Tilen
Semihuman je spletno orodje in orodje s podprtim vmesnikom API, ki zazna besedilo, ustvarjeno z umetno inteligenco, in ga naredi bolj človeškega, tako da zveni pristen. Besedilo preoblikuje za naravno berljivost, vključuje ključne besede za SEO in je zasnovano tako, da nevtralizira vzorce, ki jih iščejo detektorji, kot so Turnitin, GPTZero, Copyleaks in ZeroGPT. Posamezni načrti (Brezplačni, Osnovni in Pro) so na voljo na strani z načrti, medtem ko so načrti za razvijalce, podjetja in poslovne uporabnike za integracijo prek vmesnika API na voljo na strani za dostop do vmesnika API.
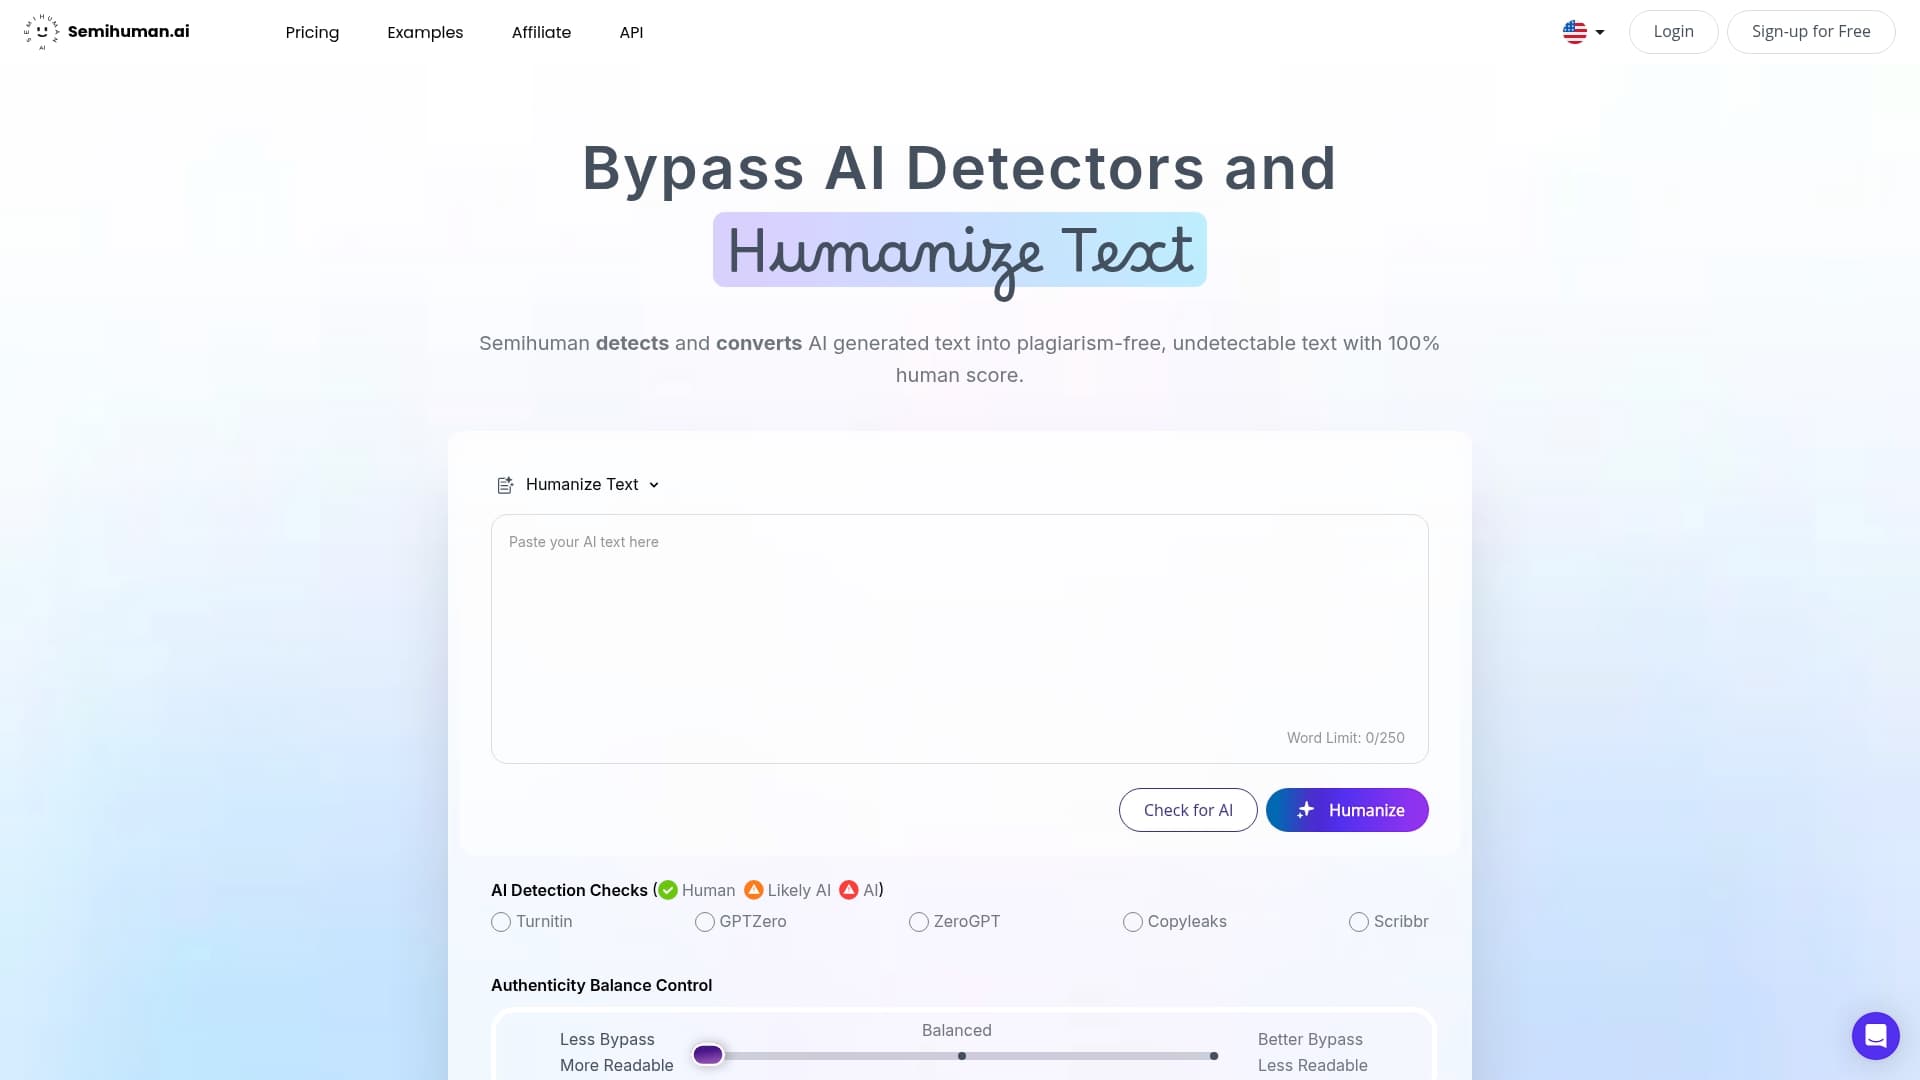
Prav tako lahko začnete na domači strani Semihuman in vanjo preprosto prilepite svoj osnutek.
Ne glede na to, ali ste urednik, učitelj ali naročnik, ki bere rezultat nekoga drugega, veljajo enaka pravila, ki jih je vredno poznati tudi takrat, ko ste sami pisec.
Za ustvarjalce je zaključek praktične narave. Ker rezultati tako zelo nihajo, je najvarneje poskrbeti, da samo besedilo zveni človeško: raznoliko, specifično in vaše. To je lastnost pisanja, ki jo lahko izboljšate, in za to je namenjeno orodje za človeško prilagajanje (humanizer). Če želite primerjati različne pristope, vam naša strokovna primerjava človeških prilagojevalcev vsebine AI in praktični primeri orodij za zaznavanje umetne inteligence nudijo več podrobnosti.
Nekaj popravkov naredi več kot katera koli nastavitev:
Poglejmo si praktičen primer. Uvod v osnutek se glasi: »V današnji digitalni krajini je trženje vsebin močna strategija, ki jo lahko podjetja izkoristijo za doseganje rasti.« Vsaka beseda je predvidljiva in stavek ne pove ničesar. Prepisana različica: »Naš blog je prejšnje četrtletje ustvaril 40 prijav, večinoma iz dveh prispevkov o cenah.« Druga različica vsebuje številko, dejstvo, ki ga poznate samo vi, in neenakomeren ritem. Preverjalci imajo v tem primeru veliko manj možnosti za opozorila, bralec pa od tega odnese več.
Ne. Preverjalnik plagiatorstva vaše besedilo primerja z obstoječimi viri. Preverjalnik umetne inteligence analizira statistične vzorce, da oceni, ali je besedilo ustvaril model, pri čemer ne kaže na izvorni vir. Besedilo ima lahko visok rezultat pri enem in nizkega pri drugem.
Odvisno od orodja in testa. Poročilo Univerze na Floridi iz maja 2026 je ugotovilo stopnjo lažno pozitivnih rezultatov od 0,05 % do 68,6 % pri petih komercialnih detektorjih v njegovih pogojih. Vsak posamezen rezultat obravnavajte kot oceno in se raje osredotočite na označene odlomke.
Da. Predvidljivo, formulaično ali šablonsko pisanje je lahko označeno, prav tako pa tudi človeško besedilo, ki je bilo rahlo izpopolnjeno z umetno inteligenco. Zaščitite se lahko z dodajanjem specifičnih podrobnosti, razgibanostjo povedi ter hranjenjem osnutkov in zapiskov.
Označen odlomke prepišite z lastnimi primeri, številkami in razgibanim ritmom ter nato ponovno preverite. Semihuman to preoblikovanje opravi namesto vas in lahko hkrati vključi tudi ključne besede za SEO. Začnete lahko z brezplačnim načrtom ali preidete na plačljivo naročnino na strani z načrti.
Da. Semihuman ponuja vmesnik API z načrtom za razvijalce, podjetja in poslovne uporabnike, ki so na voljo na strani za dostop do vmesnika API, kar ekipam omogoča izvajanje tega koraka znotraj lastnega delovnega toka.
Začetek
humanizirati
brezplačno!
Počloveči